Mac에서 실행하고, 50건·300건으로 추가 학습해 Jev와 비교하기.
📌 Intro
✅ Jev가 던진 질문: AI의 답을 소프트웨어가 바로 쓸 수 있을까?
2026년 9월 15일, TypeSafe AI는 Jev를 공개했다.
TypeSafe가 내세운 것은 소프트웨어가 직접 사용할 수 있는 판단 결과였다.
문맥과 질문을 보내면, 미리 정한 선택지나 점수와 함께 확률·confidence를 받는 방식이다.
TypeSafe는 이런 모델을 System One Model이라고 부른다. - TypeSafe의 Jev 공개 글
예를 들어 고객 요청을 읽고 긴 설명을 작성하는 대신, “어느 담당 분야로 보낼까?”, “지금 장애가 발생했는가?”, “영향 범위는 어느 정도인가?”에 답하게 한다. 애플리케이션은 그 결과를 받아 담당자를 정하거나 다음 처리 단계로 분기한다.
이 글에서 말하는 Decision Model은 문맥을 읽고, 소프트웨어의 다음 행동에 필요한 선택이나 점수를 반환하는 모델이다.
분류나 점수화 자체가 새로 생긴 문제는 아니다.
내가 이 흐름에서 주목한 점은 여러 자연어 판단을 API로 호출하고, 결과를 코드의 분기 조건으로 조합하는 방식을 전면에 내세웠다는 것이다.
10월 1일 공개된 Strands Decider 소개 글도 Jev 출시 이후 이 모델 유형이 관심을 받고 있다고 설명한다.
Jev에서 시작해 AWS의 공개 모델까지 이어지는 흐름을 살펴볼 이유다. Strands Decider 공식 공개 글
✅ Agent가 행동할수록 작은 판단도 중요해진다
Agent가 하나의 요청을 처리하는 동안에도 여러 번 판단해야 한다.
어느 모델을 쓸지, 어떤 도구를 호출할지, 입력 정보가 충분한지, 결과를 그대로 사용자에게 전달해도 되는지를 결정한다.
이런 판단이 반복되는 시스템에서는 다음 세 가지를 함께 봐야 한다.
- 비용과 지연:
짧은 선택을 위해 모델을 여러 번 호출하면 호출 비용과 대기 시간이 누적된다. 판단 전용 모델은 이런 반복 작업의 부담을 줄이려는 접근이다. 실제 이득은 입력 길이·실행 환경·요구 정확도에 따라 측정해야 한다. - 코드와의 연결:
“아마 인프라 문제인 것 같습니다”라는 문장을 해석하는 과정 대신, 코드가 처리할 수 있는 담당 분야나 점수를 받는다. 일반 LLM의 구조화된 출력으로도 가능하므로, 형식뿐 아니라 정확도·비용·지연을 함께 비교해야 한다. - 불확실성의 처리:
모델이 고른 답과 확률·confidence를 받아 자동 처리할지, 추가 정보를 요청할지, 사람에게 넘길지 설계할 수 있다. 단, 높은 점수가 실제 정답률과 맞는지는 내 데이터에서 검증해야 한다.
이는 TypeSafe와 Strands가 제시한 활용 방향을 바탕으로 내가 중요하다고 본 설계 관점이다.
생성 모델이 설명과 복잡한 문제 해결을 맡고, 판단 모델이 반복되는 선택을 맡으며, 실제 실행 조건은 코드로 관리하는 구성을 시험해 볼 수 있다.
판단 모델도 틀릴 수 있으므로 반환값 자체가 실행의 안전성을 보장하지는 않는다.
✅ AWS의 Strands Decider로 직접 확인할 수 있는 것
AWS가 공개한 Strands Agents SDK는 agent를 구성하는 오픈소스 프레임워크다.
AWS는 실험 프로젝트를 위한 별도 GitHub 조직인 Strands Labs를 통해 새로운 agent 개발 방식을 공개하고 있다. Strands Decider 2B는 이 생태계에 추가된 작은 판단 모델이다. AWS의 Strands Agents 소개, AWS의 Strands Labs 소개
공식 예시에서는 Amazon Bedrock의 생성 모델을 사용하는 Strands agent가 날씨 도구를 호출하기 전에, 로컬 Decider가 도시 이름의 근거와 추가 질문의 필요성을 판단한다. 사용자가 도시를 말하지 않았다면, 임의의 도시로 도구를 실행하기 전에 되묻게 하는 구조다. Strands의 공식 예시
Strands Decider는 모델 가중치뿐 아니라 학습 데이터와 코드도 공개했다. 그래서 API의 응답을 비교하는 데서 더 나아가, 로컬에서 구조를 살펴보고 내 예시로 추가 학습할 수 있다.
The New Stack의 AWS Strands Decider 소개 기사도 이 로컬 실행과 공개 학습 자료에 주목한다.
AWS Community Builder로서 그 과정을 직접 확인하고 공유하고 싶었다.
여기서 선택지 밖의 답을 만들지 않는 것과 올바른 선택지를 고르는 것은 다르다. 그래서 이번 실험의 질문을 두 가지로 잡았다. 추가 학습 없이 쓰면 Jev에 비해 어느 정도일까? 부족한 부분은 내가 준비한 예시로 학습시켜 보완할 수 있을까?
이번 한국어 요청 300개에서는 Strands Decider와 Jev의 차이가 컸다.
별도로 만든 50건·300건의 예시를 학습한 뒤에는 차이가 줄었다.
이 글에서는 판단 모델의 개념과 구조를 이해한 뒤, 환경 준비부터 비교·학습·검증까지 따라간다.
실행 범위는 Mac에서 완성된 Strands Decider v19를 직접 호출하고, 내 업무 예시에 맞춰 추가 학습·평가하는 데까지다.
앞의 Amazon Bedrock 연동은 공식 예시의 구조를 설명한 것이다.
공식 모델과 손실 함수를 사용하되, 기존 LoRA와 pointer head를 보존하는 별도 학습 실행기를 썼다.
공식 전체 학습 recipe의 재현과는 구분한다.
아래 성능 수치는 이 합성 데이터에서 관측한 결과이며, 실제 업무 전반에서의 성능을 대표하지 않는다.
👉 Step 01. Agent에 판단 전용 모델이 필요한 이유를 이해한다
먼저 대화와 판단을 나누어 생각해 보자. “이 장애를 어떻게 해결할까?”에는 상황을 설명하고 해결 방법을 제안하는 긴 답변이 필요하다. 반면 “현재 장애인가?”, “인프라 담당에게 보낼까?”에는 정해진 선택지 중 하나가 필요하다.
일반 LLM도 구조화된 출력으로 이런 판단을 할 수 있다. Decision Model에서 살펴볼 점은 선택과 점수 계산에 맞춘 작은 모델을 별도로 실행하고, 내 판단 기준에 맞춰 추가 학습할 수 있다는 것이다.
Strands의 공식 소개도 요청 분류, 모델·도구 선택과 행동 전 검사 등을 활용 대상으로 든다. - 공식 활용 설명
| 방식 | 잘 맞는 작업 | 이번 실습과 연결하면 |
|---|---|---|
| 명시적인 규칙 | 고정된 형식·조건을 정확히 검사 | 필수 항목이나 허용된 계정 목록 검사 |
| 일반적인 고정 라벨 분류기 | 미리 정한 범주를 반복 분류 | 학습한 담당 분야 중 하나를 선택 |
| 범용 생성 LLM | 설명, 추론, 대화와 코드 생성 | 장애 원인을 분석하고 해결 절차를 작성 |
| Strands Decider | 요청에 제공한 선택지·판단 기준으로 분류하거나 점수화 | 담당 분야, 현재 장애 여부와 영향 범위를 반환 |
예를 들어 “지난주 502는 복구했고 원인을 정리해 달라”와 “지금 업로드 요청이 502로 실패한다”에는 모두 오류 코드가 있다. 하지만 현재 장애 여부는 다르다. 이런 문맥을 판단하는 문제를 이번 실습에서 다룬다. 여기의 두 문장은 개념 설명용 예시다.
✅ 정해진 형식으로 답해도 판단은 틀릴 수 있다
Strands Decider는 제공된 선택지에 점수를 붙인다. 선택지에 없는 답을 새로 생성하지 않지만, 틀린 선택지에 높은 점수를 줄 수는 있다. 응답 형식의 유효성, 정답을 맞히는 성능, 확률의 신뢰성은 서로 다른 검사 대상이다.
이 구분 때문에 실행 성공 화면만으로 실습을 끝내지 않는다. 같은 문장으로 원본과 학습 후 모델을 비교하고, 놓친 장애와 잘못 감지한 장애를 따로 센다. 로컬 실행의 응답 시간도 실제 측정으로 확인한다.
👉 Step 02. Qwen 2B가 판단 모델이 되는 구조를 이해한다
Strands Decider의 기반 모델은 Qwen/Qwen3.5-2B-Base 모델이다. 문장을 생성하는 출력층을 선택지를 평가하는 pointer head로 바꾸고, 작은 추가 가중치인 LoRA를 붙였다. 긴 답변을 생성하는 대신 한 번의 계산으로 요청에 포함된 선택지의 점수를 구한다. 공식 모델 구조
이번 실습의 출발점은 이미 학습된 Strands Decider v19다. 기반 Qwen 모델을 처음부터 학습한 것이 아니라, v19의 기존 LoRA와 pointer head를 이어서 학습했다. LoRA는 기반 모델의 원래 가중치를 고정한 채 덧붙인 작은 가중치를 학습하는 방법이다.
| 모델 | 이 글에서의 역할 |
|---|---|
Qwen/Qwen3.5-2B-Base | Strands Decider의 기반 언어모델 |
Qwen3.5-4B | 원래 v19 학습에서 일부 다단계 예시의 정답 분포를 만든 teacher. 이번 추가 학습에서는 사용하지 않음 |
StrandsAgents/strands-decider-2B-hobson-v19 | 내가 실행하고, 50건·300건 조건의 출발점으로 사용한 완성 모델 |
4B teacher와 2B 실행 모델은 역할이 다르다.
다단계 예시는 여러 판단 단계를 이어 수행하는 학습 예시를 뜻한다.
두 모델의 관계는 공식 v19 모델 카드에 설명되어 있다.
그렇다면 왜 2B일까?
2B는 약 20억 개의 파라미터 규모를 뜻한다.제작자는 공식 README의 Why 2B? 항목에서 두 가지 이유를 설명한다.
- 실험하기 쉬운 크기:
공식 전체 학습 recipe를 RTX 3090 한 대에서 약 11시간에 다시 실행할 수 있고, Apple Silicon Mac에서도 모델을 서빙할 수 있다.- 크기와 판단 능력의 균형:
작아서 여러 아이디어를 시험하기 쉬우면서, 의미 있는 판단 작업을 수행할 만큼의 규모라고 보았다.이는 제작자의 설계 이유다. 모든 과제에서 2B가 가장 좋다는 비교 결과는 아니다.
Mac에서 추론할 수 있다는 설명과 RTX 3090에서 전체 recipe를 학습한 설명도 구분해야 한다. 공식 README: Why 2B?
내가 이 모델을 고른 이유는 공개된 기준 모델 v19를 M4 Pro·메모리 24 GB에서 실행하고, 별도 GPU 대여 없이 업무 예시에 맞춰 추가 학습해 볼 수 있었기 때문이다. 이번 실험에서 2B와 4B를 비교해 2B를 선택한 것은 아니다.
✅ LoRA와 pointer head는 서로 다른 부분을 바꾼다
가중치는 모델의 계산에 쓰이는 학습 가능한 숫자다. LoRA는 기반 가중치를 고정하고, 일부 계산에 작은 추가 가중치를 붙여 학습한다. 이 모델의 pointer head는 입력에 들어 있는 선택지별 점수를 계산하는 출력층이다. 이번 실습에서는 두 부분을 모두 이어서 학습한다.
입력 문장 + 질문 + 선택지
        ↓
Qwen 2B 기반 모델 + 기존 LoRA
        ↓
pointer head가 선택지별 점수 계산
        ↓
선택지의 확률 → 담당 분야 / 장애 여부 / 영향 점수
질문의 표현을 바꾸는 것은 모델에 주는 입력을 바꾸는 일이다. 추가 학습은 정답 예시로 LoRA와 출력층의 가중치를 바꾸는 일이다. 기반 가중치를 고정해도 최종 판단은 달라질 수 있으므로, 다른 과제의 성능이 유지되는지는 별도로 확인해야 한다.
✅ MLX로 실행하고 MPS로 학습한 이유
MLX는 Apple Silicon을 위한 머신러닝 프레임워크다. MPS는 이 글에서 PyTorch가 Mac의 GPU를 사용하는 실행 경로를 가리킨다. 모델 이름이나 학습 방법의 이름이 아니다. Apple의 MLX 설명, PyTorch의 MPS 설명
| 작업 | 이번 실습의 실행 경로 | 공식 지원과 이번 구현의 관계 |
|---|---|---|
| 원본 모델 추론·서빙 | 공식 --device mlx 백엔드 | 사용한 upstream 버전에서 지원하는 경로 |
| LoRA·pointer head 추가 학습 | PyTorch MPS | 공식 모델·손실 함수를 호출하는 별도 학습 실행기 |
| 저장 후 재평가 | 같은 공식 MLX 백엔드 | 학습한 checkpoint를 읽어 같은 문장으로 평가 |
사용한 고정 버전의 공식 문서에는 MLX 설치 extra와 --device mlx가 명시돼 있다. MLX는 직접 선택하는 옵션이며, 설치만 하고 --device를 생략하면 Mac에서 기본 선택되는 경로는 MPS다. 당시 PyPI 0.1.0에는 이 extra가 없어서 고정한 source checkout으로 환경을 구성했다. 고정 버전의 공식 Mac 추론 안내
이 구현은 기반 모델 계산을 MLX·Metal로 실행하고, pointer head는 기존 PyTorch CPU 코드를 사용한다. 따라서 “MLX로 구동했다”는 말이 모든 연산을 MLX로 다시 구현했다는 뜻은 아니다.
학습에는 기존 PyTorch 모델과 손실 함수를 이어 쓸 수 있는 MPS 실행기를 사용했다. 공식 MLX 추론 지원과 이번에 구현한 MPS 추가 학습은 별개다. Strands Decider의 공식 전체 학습 recipe는 Linux/WSL2와 NVIDIA GPU를 기준으로 하며, 이번 Mac 학습은 그 전체 절차를 재현한 것이 아니다.
🚀 실습 전에
-
실습 자료는 개인 GitHub 저장소에서 받는다. 코드·합성 데이터·단계별 안내를 제공하며, 기존 실행 결과·모델 가중치·증적 PNG·HTML은 배포하지 않는다.
-
직접 학습하려면 Apple Silicon Mac, native arm64 Python 3.12,
uv,git이 필요하다. 이 실험은 M4 Pro·메모리 24 GB에서 실행했다. 모델 다운로드와 설치를 위한 네트워크도 필요하다. -
아래 명령은 프로젝트 루트, 또는 공유 ZIP을 풀어
pyproject.toml과scripts/가 보이는 디렉터리에서 실행한다. 직접 실습할 때는 압축을 별도 작업 폴더에 풀어 원본 공유 파일을 보존한다. -
명령은 같은 터미널에서 순서대로 실행한다. 새 터미널로 옮기면
RUNTIME,STUDY_DIR,BASELINE_RUN에 앞서 선택한 경로를 다시 설정한다. -
파일의
S0,S50,S300은 각각 Strands Decider, Strands Decider + 학습 50건, Strands Decider + 학습 300건이다. 숫자는 추가로 학습한 예시 개수다. 저장된 실험에서는 예시를 보여 주는 순서를 바꾸어 세 번 학습했다. 파일의seed는 그 순서를 다시 만들기 위한 번호다.
🧪 실습 환경 준비
xgro/strands-decider-hands-on을 clone하고 의존성을 설치한다.
git clone https://github.com/xgro/strands-decider-hands-on.git
cd strands-decider-hands-on
uv sync --locked
본 실습에 앞서 고정한 source와 v19 가중치를 준비하고, 로컬 원본 모델을 실행한다.
Mac에는 native arm64 Python 3.12, uv, git과 MPS를 지원하는 Apple Silicon이 필요하다. 실험은 M4 Pro·24 GB에서 완료했다. 저장소에는 학습 데이터와 코드가 있지만 model weights나 실행 runtime은 없다. 아래 bootstrap은 고정한 upstream source와 모델 파일을 저장소 밖의 새 경로에 설치한다. 자세한 환경 안내는 저장소의 docs/02-setup.md를 참고한다.
RUNTIME="$HOME/.local/share/decision-model-lab/decider-macos-arm64-py312"

# 먼저 설치 계획만 확인한다.
python3 scripts/bootstrap_runtime.py --runtime-dir "$RUNTIME"

# 새 runtime과 필요한 모델 파일을 준비한다.
python3 scripts/bootstrap_runtime.py --runtime-dir "$RUNTIME" --execute
python3 scripts/bootstrap_runtime.py --verify-existing "$RUNTIME"
예상 산출물:
runtime 아래 model.json, bootstrap-manifest.json, 고정 모델 snapshot이 생긴다.
확인: --verify-existing가 성공하면 package와 파일 hash가 선언값과 맞는다. 이 확인은 모델 추론이나 품질 평가까지 증명하지 않는다.
첫 bootstrap에는 GitHub, Python package index, Hugging Face 접근이 필요할 수 있다.
기존 Hugging Face cache를 재사용해도 source checkout과 package 설치는 별도이며, 모두 Jev API 호출과 구분된다.
runtime 준비가 끝나면 원본 서버를 시작한다. 이미 같은 runtime의 정상 원본 서버가 있다면 시작 명령을 반복하지 않는다.
uv run --locked python scripts/start_original_server.py --runtime-dir "$RUNTIME"공개용 서버는 터미널 A에서 foreground로 실행한다. 서버가 준비되면 터미널 B의 저장소 루트에서 이후 명령을 실행한다.
학습 전에 터미널 A에서 Ctrl+C로 종료하고, 학습 후 평가할 모델을 다시 실행한다.
터미널 B에서 모델 ID와 health를 확인한다.
uv run --locked decision-lab check --provider decider확인: 로컬 모델이 strands-decider-2B-hobson-v19, 실행 경로가 mlx, window가 4096인지 본다. 이 명령은 추론하지 않는다. 공개용 runner는 서버를 자동 종료·복원하지 않으므로, Step 04 학습 전에 터미널 A에서 직접 종료한다.
👉 Step 03. 같은 질문으로 원본 Strands Decider와 Jev를 비교한다
AWS 운영을 돕는 agent를 만든다고 가정해 보자.
요청을 어느 분야로 보낼지, 현재 장애인지, 영향이 얼마나 넓은지를 먼저 가려야 한다. 이번에는 이 판단을 세 가지 질문으로 바꾸고, 모든 모델에 같은 기준을 사용했다.
업무 요청을 받은 agent가 도구를 실행하기 전에 담당 분야, 현재 장애 여부와 영향 범위를 고르는 상황이다. 판단 모델은 각 질문에 대해 선택지나 점수를 반환한다.
| 판단 | 이번 실험의 질문 |
|---|---|
| 담당 분야 | 인프라·모델 운영·보안·일반 문의·정보 부족 중 어디에 해당하나? |
| 현재 장애 | 지금 실제 문제가 발생했나, 아니면 문의나 과거 사례인가? |
| 영향 범위 | 현재 영향이 없는지, 한 사용자에 한정되는지, 더 넓은 범위인지 0~3점으로 표현하면? |
Strands Decider는 내 Mac에서 실행하는 모델이고, Jev는 API로 호출한 비교 대상이다. 처음 비교할 때 두 모델에 같은 문장과 판단 기준을 보냈고, 후속 학습 비교에서는 저장된 Jev 응답을 재사용했다.
Jev의 답 자체가 정답은 아니다.
정답은 별도로 작성했으며,
이번에는 AI가 만들고 검토한 합성 자료를 사용했다.
여기서 state는 판단할 입력 문장, questions는 질문과 기준, expected는 별도로 작성한 정답이다.
평가 API에는 입력과 질문을 보내고, 정답은 응답을 받은 뒤 비교한다.
학습할 때는 같은 정답을 가중치 갱신의 목표로 사용한다.
이번 실험의 입력 문장(state)은 한국어이고, 공통 질문과 판단 기준은 영어다.
한국어로 작성된 모든 형태의 질문을 시험한 결과로 확대해서 읽으면 안 된다.
✅ 먼저 원본이 놓친 판단을 본다
처음 비교에서는 평가 문장 300개를 Strands Decider와 Jev에 각각 보냈다.
아래 명령은 그때 저장한 응답만 읽는다.
Jev를 새로 호출하지 않는다.
학습 전 결과부터 보면 차이가 분명하다.
| 무엇을 확인했나 | Jev · 비교 기준 | Strands Decider |
|---|---|---|
| 담당 분야를 맞힌 문장 | 296 / 300개 | 180 / 300개 |
| 실제 장애를 놓친 문장 | 5 / 124개 | 92 / 124개 |
| 장애가 아닌데 장애라고 판단한 문장 | 0 / 176개 | 0 / 176개 |
이 차이가 실제로 어떤 문장에서 드러났는지 먼저 확인한다. 뒤의 학습 비교에서도 처음 저장한 Jev 응답을 같은 기준으로 사용한다.
직접 실습할 때는 같은 평가 데이터로 새 기준선을 만든다. 아래 명령은 로컬 Decider만 호출한다.
uv run --locked decision-lab compare \
  --dataset datasets/baseline-300-ai-v1/cases.jsonl \
  --allow-ai-reviewed-labels --provider decider --output-dir runs/baseline

# 이번에 생성된 실행 폴더가 하나일 때만 사용한다.
BASELINE_RUN=$(find runs/baseline -mindepth 1 -maxdepth 1 -type d)
uv run --locked python scripts/summarize_baseline.py "$BASELINE_RUN"
여러 번 실행했다면 BASELINE_RUN에 이번에 비교할 실행 폴더 하나를 직접 지정한다. 과거 작성자의 실행 시각이나 폴더는 필요하지 않다.
확인: 생성된 baseline-summary.json의 case_errors와 responses.jsonl에서 eval300-infra-001을 찾는다. 이 요청은 다음과 같다.
이 요청은 다음과 같다.
새 컨테이너 이미지 배포 뒤 readiness probe가 실제 준비 완료보다 일찍 성공으로 바뀌고, 바로 뒤따른 요청 하나가 502를 반환합니다. 현재 다른 요청과 복제본은 정상이고 한 사용자의 업로드 요청만 실패했습니다. probe 조건과 시작 지연을 확인해 주세요.
이 문장의 정답은 현재 장애이며,
영향은 한 사용자·요청에 한정된다(1점).
Strands Decider는 장애일 확률을 약 33%로 표시했다. 이번에는 50% 이상을 장애로 정했으므로 이 문제를 놓쳤다.
Jev는 80%를 표시해 장애로 판단했다.
이 요청을 학습 후에 다시 확인해, 같은 문제가 여전히 남아 있는지 살펴본다.
👉 Step 04. 별도 예시 50건·300건으로 LoRA와 출력층을 학습한다
학습 전 비교에서 부족한 판단을 확인했으니, 이제 모델에 보여 줄 입력과 정답 예시를 준비한다.
평가 문장 300개는 datasets/baseline-300-ai-v1/cases.jsonl에 있다.
학습 후에도 같은 문장과 판단 기준으로 비교할 것이므로, 이 문장들은 학습에 넣지 않는다.
추가 학습에는 별도로 만든 예시 300개를 사용하며, 그중 고정된 50개가 작은 학습 조건이다.
datasets/adaptation-300-ai-v1/train-50.jsonl과 train-300.jsonl에서 입력 문장(state)과 정답(expected)을 직접 볼 수 있다.
학습 데이터와 평가 데이터가 별도라는 것과, 평가를 처음 보는 문장으로 한 번만 수행했다는 것은 다르다. 이번에는 같은 평가 문장을 반복 확인했으므로, 마지막 절에서 그 한계를 따로 설명한다.
✅ 예시 수는 달라도 가중치 갱신 횟수는 맞춘다
Epoch는 학습 예시 전체를 한 번 훑는 횟수다. 50건 조건은 같은 예시를 여섯 번, 300건 조건은 한 번 사용한다. 두 조건 모두 가중치를 300회 갱신하도록 맞췄다. 더 많은 횟수로 학습하는 효과보다, 같은 횟수에서 더 다양한 예시를 보는 효과를 살펴보려는 설정이다.
✅ 입력과 정답이 가중치 변경으로 이어지는 과정
이제 준비한 예시로 모델의 가중치를 갱신한다. 두 조건은 같은 Strands Decider v19에서 각각 출발한다. 300건 모델은 50건 모델을 이어서 학습하지 않는다.
이번 학습은 완성된 Strands Decider v19에 대한 지도 미세조정이다. 입력과 정답을 함께 준비하고, 정답 선택지에 더 높은 확률을 주도록 모델의 일부 가중치를 바꾼다.
정답 선택지에 낮은 확률을 주면 손실(loss)이 커진다. backward()는 손실을 줄이기 위해 가중치를 어느 방향으로 바꿀지 기울기를 계산한다. Optimizer인 AdamW는 그 기울기를 이용해 학습 대상으로 지정한 가중치를 갱신한다. 이 갱신 한 번을 여기서는 update라고 센다.
Strands Decider v19는 Qwen/Qwen3.5-2B-Base에 작은 추가 가중치인 LoRA와 답을 선택하는 출력층인 pointer head를 붙인 모델이다. 이번에는 기반 모델의 원래 가중치를 고정하고, 이미 학습된 LoRA와 pointer head를 이어서 학습했다. 공식 모델 구성
| 항목 | 이번 실습의 설정 |
|---|---|
| 학습 대상 | 기존 LoRA와 pointer head, 총 17,872,384개 파라미터 |
| 고정 대상 | 기반 모델의 원래 가중치, 총 1,881,825,088개 파라미터 |
| 정답과 손실 | 정답 선택지의 확률을 높이는 분류 손실. 공식 모델의 손실 함수를 사용 |
| 가중치 갱신 | AdamW, 학습률 1e-5, weight decay 0, gradient clip 1 |
| 한 번에 학습하는 단위 | 한 문장의 세 판단. 50문장은 질문·정답 150개, 300문장은 900개 |
| 갱신 횟수 | 두 조건 모두 300회. 총 질문·정답 노출 횟수는 각각 900회 |
문장과 질문을 공식 입력 형식으로 만들고, 공식 모델과 데이터 묶음 생성기(SystemOneCollator)를 사용했다.
손실을 계산한 뒤 backward()로 기울기를 구하고, AdamW로 가중치를 갱신한다. 학습할 때는 선택지 순서도 섞는다.
영향 범위 역시 0~3점 선택지의 확률을 학습하며, 추론 결과는 그 확률로 계산한 기대 점수다.
학습 실행기는 별도로 작성했다. 이번에 고정한 upstream의 init_from 경로는 기존 출력층을 새 출력층으로 교체하기 때문이다. 기존 v19의 판단 능력에서 출발하려고, LoRA와 pointer head를 함께 읽어 이어서 학습하는 저장소의 scripts/train_adaptation.py를 사용했다. 해당 upstream 구현
이 설정은 짧은 실습을 위한 고정 조건이다. 최적 학습률을 찾거나 validation 점수로 checkpoint를 고르지는 않았다. 마지막 300회째의 모델을 저장한다. 공식 전체 학습 recipe를 그대로 실행한 것은 아니다. 제작자의 전체 데이터·teacher 학습 절차는 고정한 버전의 공식 학습 recipe에 있다.
먼저 터미널 A의 원본 서버를 Ctrl+C로 종료해 GPU 메모리를 비운다. 저장소 루트에서 새 study 경로로 학습 계획을 확인한다. 예시를 섞는 순서 번호는 42다.
RUNTIME="$HOME/.local/share/decision-model-lab/decider-macos-arm64-py312"
STUDY_DIR="runs/adaptation-replay-seed42"
uv run --locked python scripts/run_adaptation.py \
  --runtime "$RUNTIME" --study-dir "$STUDY_DIR"

# 계획을 확인한 뒤 실제 학습·저장·재로드를 수행한다.
uv run --locked python scripts/run_adaptation.py \
  --runtime "$RUNTIME" --study-dir "$STUDY_DIR" --execute
runner는 s50/과 s300/에서 각각 300 update를 수행하고, 저장한 checkpoint를 다시 읽은 뒤 같은 300건 test를 로컬 MLX로 평가한다. Jev는 기존 응답을 재사용한다.
예상 산출물:
protocol.json,s50/train-result.json,s300/train-result.json, 각 조건의checkpoint/와reload-result.json.확인:
protocol.json의 상태가passed인지 확인한다. 기존 결과를 덮어쓰지 않도록 존재하지 않는 새STUDY_DIR를 사용한다. Jev 호출은 없다.
👉 Step 05. 가중치 변경과 저장·재로드를 확인한다
학습 명령이 끝났다는 메시지만으로 실제 가중치가 바뀌었다고 말할 수 있을까?
실행기의 성공 상태와 함께 가중치 변경, 기반 가중치 고정과 저장·재로드를 확인했다.
Step 04의 실행기가 이 검사를 함께 수행한다.
Tensor는 가중치 같은 숫자를 배열로 묶은 것이고, checkpoint는 학습한 모델을 다시 읽을 수 있게 저장한 파일 묶음이다. 학습 프로그램이 성공으로 끝났다는 메시지에 더해, 실제 가중치 변경과 저장·재로드를 검사했다.
아래는 저장된 50건·300건 조건의 세 번씩, 총 여섯 번 학습에서 확인한 결과다.
검사 저장된 실행에서 확인한 결과 첫 역전파의 기울기 LoRA와 pointer head 모두 유한하며 0이 아닌 기울기 발생 실제로 바뀐 가중치 각 실행에서 LoRA tensor 372개와 출력층 tensor 6개 변경 고정한 기반 가중치 학습 전후 전체 SHA-256 동일 저장 후 재로드 별도 PyTorch 프로세스에서 읽은 확인용 입력의 확률 차이 0.0추론 서버에서 사용 저장한 checkpoint를 MLX 서버로 읽고 평가 300개 실행
각 조건의 train-result.json에서 updates, changed_tensors, frozen_sha256_before, frozen_sha256_after를 확인한다.
reload-result.json에는 저장 전후 확인용 입력의 확률 차이인 max_abs_probability_delta가 있다.
확인용 입력은 학습 데이터에서 골랐고, 저장·재로드 검사에만 사용했다.
모델 선택이나 성능 점수 계산에는 사용하지 않았다.
저장·재로드 확률 차이 0.0은 같은 PyTorch 경로의 확인용 입력에서 얻은 결과다. MLX 전환 후에는 별도로 확률을 대조하고 평가를 실행했다.
이 검사들은 가중치를 실제로 갱신하고 저장한 모델로 평가했다는 실행 증거다. 학습에 넣지 않은 평가 문장에서의 결과는 다음 Step에서 확인한다. 다만 이미 살펴본 같은 평가 문장을 반복 사용했으므로, 새로운 업무 문장에 대한 성능은 마지막 절의 범위에 따라 해석한다.
👉 Step 06. 같은 평가 문장으로 Jev와 다시 비교한다
저장한 모델의 답을 원본 Strands Decider·Jev와 같은 평가 문장으로 비교한다. 학습 코드가 실행됐는지와, 판단 결과가 달라졌는지는 별도로 확인한다.
터미널 A에서 먼저 50건 학습 모델을 실행한다. 저장된 checkpoint 해시를 확인한 뒤 MLX로 서빙한다. Step 04에서 다른 study 경로를 사용했다면 아래 값도 같은 경로로 바꾼다.
RUNTIME="$HOME/.local/share/decision-model-lab/decider-macos-arm64-py312"
STUDY_DIR="runs/adaptation-replay-seed42"
uv run --locked python scripts/start_original_server.py \
  --runtime-dir "$RUNTIME" --training-run "$STUDY_DIR/s50"
터미널 B에서 같은 평가 문장으로 새 응답을 저장한다.
uv run --locked decision-lab compare \
  --dataset datasets/baseline-300-ai-v1/cases.jsonl \
  --allow-ai-reviewed-labels --provider decider \
  --decider-model hands-on-s50 --output-dir runs/after-s50
터미널 A에서 Ctrl+C로 종료한 뒤 300건 학습 모델을 실행한다.
uv run --locked python scripts/start_original_server.py \
  --runtime-dir "$RUNTIME" --training-run "$STUDY_DIR/s300"
서버가 준비되면 터미널 B에서 같은 평가를 수행한다.
uv run --locked decision-lab compare \
  --dataset datasets/baseline-300-ai-v1/cases.jsonl \
  --allow-ai-reviewed-labels --provider decider \
  --decider-model hands-on-s300 --output-dir runs/after-s300
각 폴더에 실행 결과가 하나씩 있다면 다음 명령으로 비교한다. 여러 번 실행한 경우에는 비교할 실행 폴더 두 개를 직접 지정한다.
python3 scripts/compare_results.py runs/baseline/*/ runs/after-s50/*/
python3 scripts/compare_results.py runs/baseline/*/ runs/after-s300/*/
이 명령은 저장된 입력·질문·정답의 일치를 검사하고 지표를 다시 계산한다. 모델·API 호출과 PNG·HTML 생성은 없다. 실행 후 터미널 A의 서버는 Ctrl+C로 종료한다.
공개 실습은 순서 번호 42의 한 번 학습이다. 내가 저장한 같은 번호의 결과에서는 분류 점수가 50건 학습 0.9010, 300건 학습 0.9333이었다. 새 실행이 같은 소수점까지 일치한다고 보장하지 않는다. 다음 절의 세 번 평균과도 구분해서 본다.
✅ 처음 놓친 요청은 어떻게 바뀌었나
Step 03에서 본 readiness probe 요청을 같은 설정 번호 42의 저장된 결과로 다시 확인했다.
50건·300건 학습 모델은 모두 장애일 확률을 100%로 표시해 이 문제를 찾아냈다. 이 확률은 모델이 답에 붙인 값이며 실제 정답률은 아니다. 한 사례의 개선으로 전체 품질을 결론 내리지는 않는다.
✅ Jev와의 차이는 얼마나 줄었나
담당 분야를 고르는 성능은 분류 점수(macro-F1)로 비교했다.
0~1 사이이며 높을수록 좋다.
각 분야에서 잘못 고르는 경우와 놓치는 경우를 함께 반영하고, 다섯 분야의 점수를 같은 비중으로 평균한다.
0.941은 정답률 94.1%라는 뜻이 아니다.
비교 대상 담당 분야 분류 점수 Jev보다 낮은 정도 Jev · 기준 0.987 — Strands Decider 0.621 0.366 Strands Decider + 학습 50건 0.904 0.083 Strands Decider + 학습 300건 0.941 0.046
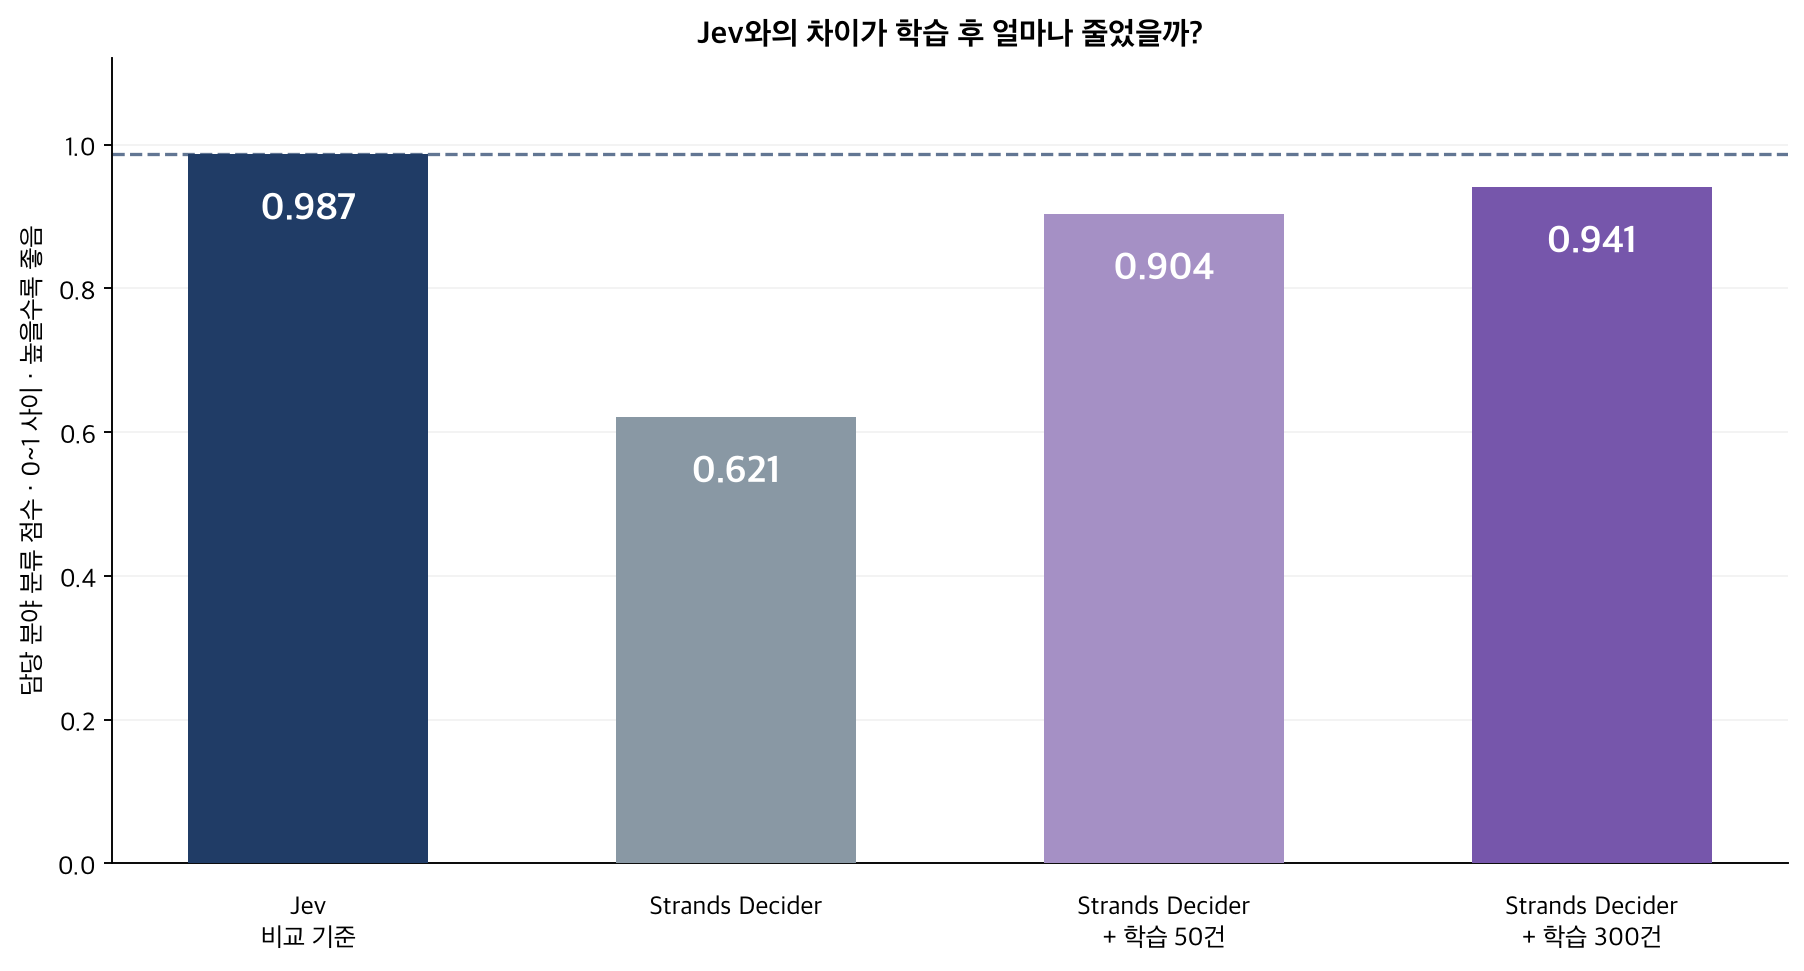
이 평가에서는 원본과 Jev 사이의 큰 차이가 50건 학습 후 줄었고, 300건 학습 후 더 줄었다.
학습 순서를 바꾸어 세 번 실행해도 담당 분야 점수는 모두 원본보다 높았다.
그래프는 저장된 세 번의 평균이며, 위 명령으로 새로 집계한 한 번의 결과와는 구분한다.
장애를 찾는 판단은 조금 더 자세히 봐야 한다.
아래는 예시 순서를 바꾼 세 번의 학습 중 한 번에서 얻은 실제 개수다.
위 실습과 같은 설정을 사용했다. 장애 확률이 50% 이상이면 장애로 판정했다.
| 비교 대상 | 놓친 장애 · 실제 장애 124개 중 | 잘못 감지한 장애 · 비장애 176개 중 |
|---|---|---|
| Jev · 기준 | 5 | 0 |
| Strands Decider | 92 | 0 |
| Strands Decider + 학습 50건 | 8 | 4 |
| Strands Decider + 학습 300건 | 2 | 7 |
300건 학습 모델은 이 실행에서 Jev보다 장애를 덜 놓쳤다. 하지만 장애가 아닌데 장애라고 판단한 경우는 더 많았다. 분류 점수가 가까워졌다고 모든 판단이 Jev와 같아진 것은 아니다.
영향 범위의 평균 오차도 같은 실행에서 Jev 0.081점에 비해 원본 0.634점 → 50건 학습 0.118점 → 300건 학습 0.086점으로 줄었다.
0~3점에서 정답과 얼마나 떨어졌는지 평균한 값이므로 낮을수록 좋다. 정답을 모르는 5문장을 제외한 295문장의 결과다.
✅ 로컬 실행이면 응답도 더 빨랐을까?
이 실험에서는 그렇지 않았다.
저장된 300개 평가 요청의 왕복 시간 중앙값은 Jev 약 0.204초, 원본 Decider 0.430초, 50건 학습 모델 0.418초, 300건 학습 모델 0.439초였다. 학습 모델 수치는 SEED 42의 실행이다.
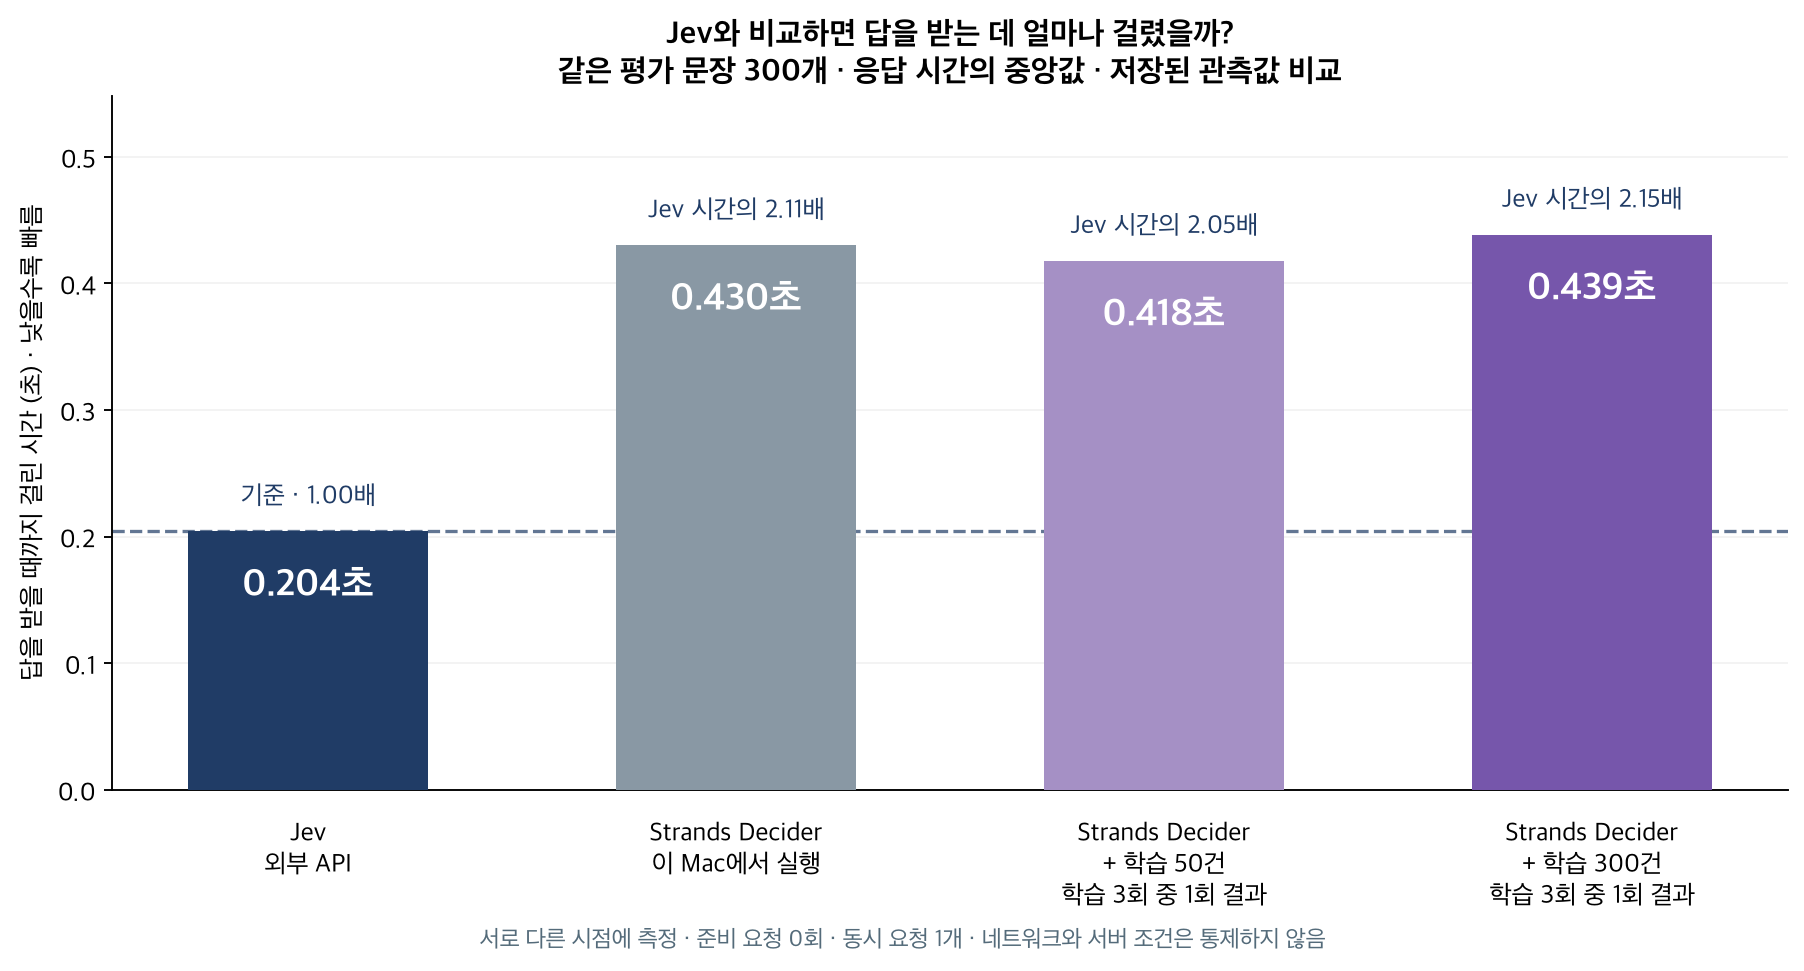
이 비교는 원격 Jev API와 M4 Pro의 로컬 서버를 각각 측정한 값이다.
요청마다 세 질문을 함께 보냈고, 동시성은 1이며 별도 준비 요청은 없었다. 측정 시점과 실행 환경도 다르다.
공식 자료의 다른 장비·입력 길이 수치와 직접 비교할 수 없으며,
“로컬 모델이라 항상 API보다 빠르다”는 결론도 낼 수 없다.
✅ 직접 실행한 결과 확인하기
저장소를 clone한 뒤 앞의 Step을 실행하면 결과는 내 컴퓨터의 runs/에 생성된다.
manifest.json에서 모델·입력·질문과 완료 상태를 확인하고, responses.jsonl에서 원본 응답·오류·경고를 확인한다.
scripts/summarize_baseline.py와 scripts/compare_results.py는 이 로컬 결과를 집계한다.
🧪 선택 실습. Jev를 새로 호출할 때만
공개용 클라이언트의 기본 provider는 로컬 Decider다.
로컬 학습과 저장된 결과의 집계에는 Jev 호출이 없다.
개인 TypeSafe API key를 설정하고 현재 요율을 확인한 뒤, 새 Jev 기준선을 만들 때만 아래 경로를 선택한다.
uv run --locked decision-lab compare \
  --dataset datasets/baseline-300-ai-v1/cases.jsonl \
  --allow-ai-reviewed-labels --provider jev \
  --max-remote-calls 300 --max-cost-usd 1 --output-dir runs/jev
이 선택 단계는 비용이 발생하는 새 원격 호출이다. 최대 300개 요청을 보내며, 앞의 로컬 학습 실습에는 필요하지 않다. $1은 2026-10-04 공개 요율로 사전 검사하는 client 측 상한이며 실제 청구액을 보장하지 않는다.
해당 요율로 예약 계산한 금액은 $0.8257536이다. 직접 호출할 때는 저장소의 docs/optional-jev.md에서 키 설정과 비용 안내를 먼저 확인한다.
Jev 응답도 runs/jev/에 새로 생성된다. 원본 또는 학습 후 실행 폴더와 scripts/compare_results.py로 비교할 수 있다. 작성자의 과거 원시 응답은 제공하지 않는다.
각 폴더에 완료된 실행이 하나씩 있을 때는 다음처럼 비교한다. 여러 번 실행했다면 비교할 폴더를 직접 지정한다.
python3 scripts/compare_results.py runs/baseline/*/ runs/jev/*/
python3 scripts/compare_results.py runs/after-s50/*/ runs/jev/*/
python3 scripts/compare_results.py runs/after-s300/*/ runs/jev/*/
📌 Conclusion
이번 실험에서 Strands Decider의 매력은 내가 필요한 판단 기준으로 모델을 바꾸고, 그 변화를 직접 확인할 수 있다는 점이었다.
Mac에서 완성된 모델을 실행하고, 별도 예시 50건·300건으로 LoRA와 pointer head를 추가 학습했다.
학습 명령이 끝나는 데서 멈추지 않고, 가중치 변경과 저장·재로드를 확인한 뒤 같은 평가 문장으로 다시 비교했다.
평가에서는 추가 학습 후 Jev와의 분류 점수 차이가 줄었다. 다만 장애를 덜 놓치는 대신 잘못 감지하는 경우가 늘었고, 로컬 모델의 응답도 Jev API보다 빠르지 않았다. 따라서 이번 결과는 내 과제에 맞춘 추가 학습의 가능성을 보여준다.
Jev를 대체할 수 있다거나 실제 업무를 바로 자동화해도 된다는 결론은 아니다.
AWS가 Strands Decider의 가중치와 학습 자료를 공개한 의미도 여기서 느낄 수 있었다. 개발자가 모델을 직접 실행하고, 판단 기준을 데이터로 표현하고, 수정한 모델을 다시 평가하는 과정을 경험할 수 있다. Agent를 설계할 때도 어느 판단을 작은 모델에 맡기고, 어떤 실행 조건을 코드로 검사하며, 언제 사람에게 넘길지 구체적으로 나누어 생각하게 된다.
다음으로 확인할 것은 새로운 요청에서도 이 판단이 유지되는지다. 사람이 정답을 검토한 미사용 데이터와 실패했을 때의 처리 기준을 먼저 준비해야 한다. 그 검증을 통과한 판단부터 Bedrock의 생성 모델과 로컬 Decider가 역할을 나누는 구성에 연결해 볼 수 있다. 어떤 판단을 맡길지 정하고, 틀렸을 때까지 확인하는 것이 이번 핸즈온에서 가져가고 싶은 기준이다.
📌 함께 읽어볼 자료