0. 프롤로그: CPU의 가장 비싼 실수

지난 포스팅에서 우리는 CPU가 성능을 극대화하기 위해 결과를 모르는 상태에서 미리 실행하는 '추측 실행(Speculative Execution)'을 한다고 배웠다. 하지만 모든 도박에는 리스크가 따른다.
만약 CPU의 예측이 빗나간다면(Misprediction) 어떤 일이 벌어질까? 단순히 "조금 느려진다" 정도가 아니다. 하드웨어 관점에서 이것은 '재앙'에 가깝다. 오늘은 그 실패의 비용을 숫자로 계산해보고, 이를 극복하기 위한 개발자의 전략을 알아본다.
1. 실패의 메커니즘: 파이프라인 플러시 (Pipeline Flush)
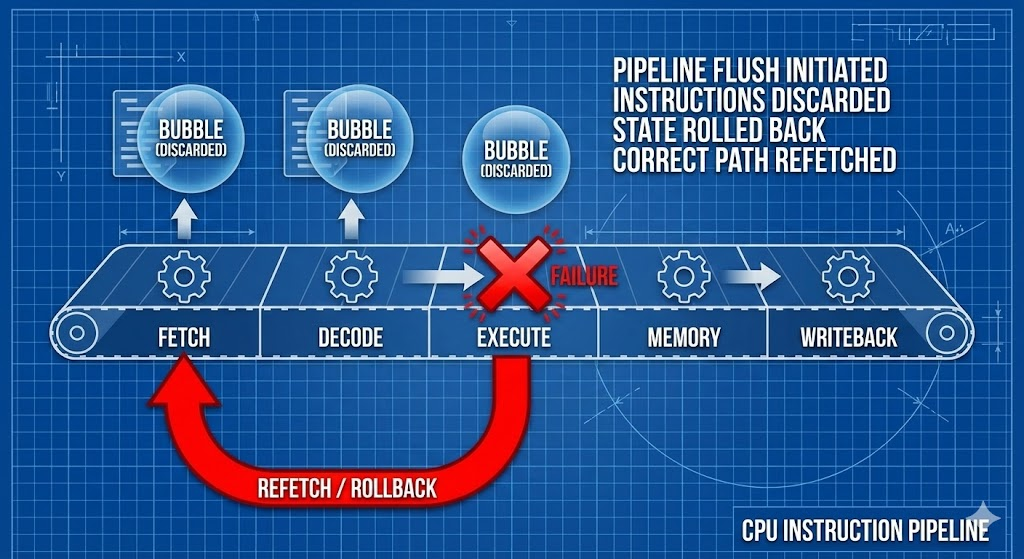
분기 예측이 틀렸다는 사실은 파이프라인의 깊숙한 곳(Execute 단계)에 도달해서야 밝혀진다. 이때 CPU는 비상 제동을 건다.
1.1. 사고 수습 4단계
- Stop (중단): 잘못된 경로(Wrong Path)로 들어선 파이프라인 실행을 즉시 멈춘다.
- Flush (폐기): 이미 파이프라인 앞단(Fetch, Decode)에 들어와 처리 중이던 모든 명령어들을 즉시 삭제(Discard)한다. 이 과정에서 파이프라인에 빈 공간인 '버블(Bubble)'이 생긴다.
- Rollback (복구): 레지스터와 CPU 상태를 분기 직전 시점으로 되돌린다.
- Refetch (재인출): 올바른 경로(Correct Path)의 주소로 다시 가서 명령어를 처음부터 가져온다.
1.2. 비용의 정량화 (The Cost of Flush)
"잠깐 멈추는 것"과 "다 버리고 다시 하는 것"은 차원이 다르다.
- 패널티 공식:
손실 사이클 ≈ 파이프라인 깊이 (Pipeline Depth) - 현실: 현대 고성능 CPU(Intel Core, AMD Ryzen 등)는 보통 15~20단계의 깊은 파이프라인을 가진다.
- 결과: 예측이 한 번 틀릴 때마다 CPU는 15~20 사이클(Clock) 동안 아무런 유의미한 작업을 하지 못한다. 4GHz CPU라면 엄청난 낭비다.
2. 🔬 [Deep Dive] 심화 학습: 왜 고성능 CPU일수록 더 치명적인가?
여기서 시니어 개발자가 주목해야 할 역설이 있다. "CPU 스펙이 좋아질수록, 예측 실패의 타격은 기하급수적으로 커진다."
2.1. 슈퍼스칼라(Superscalar)의 배신
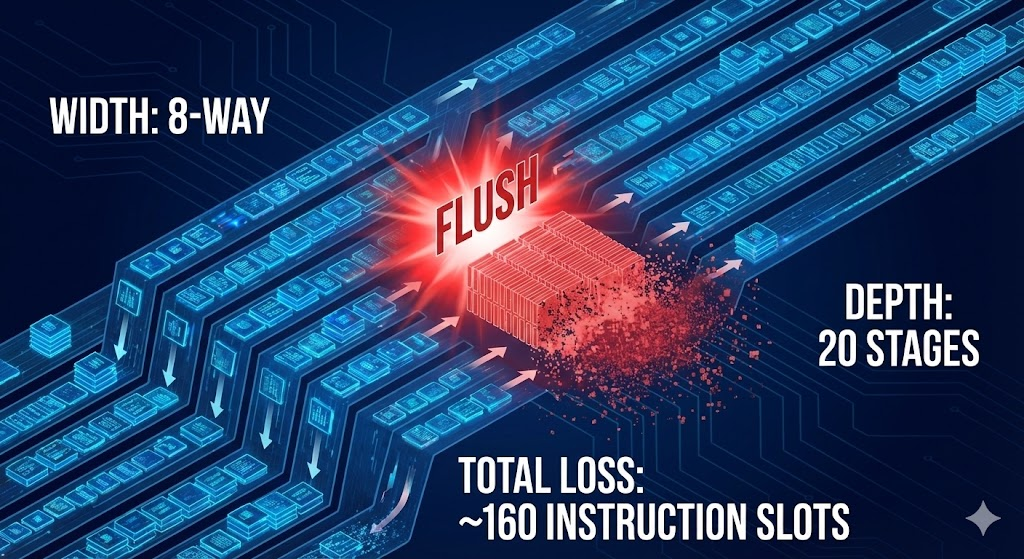
최신 CPU는 파이프라인 하나만 돌리는 게 아니라, 한 번에 4~8개의 명령어를 동시에 처리하는 슈퍼스칼라(Superscalar) 구조다.
- 너비(Width): 8-way (한 틱에 8개 명령어 처리)
- 깊이(Depth): 20단계
- 증발하는 작업량: 20단계 × 8개 = 160개의 명령어 슬롯
즉, 예측 실패 한 번에 160개의 잠재적 작업이 공중분해된다. 이것이 고성능 CPU일수록 분기 예측 정확도(BHT)에 목숨을 거는 이유다.
2.2. 소프트웨어적 해결: Branchless Programming
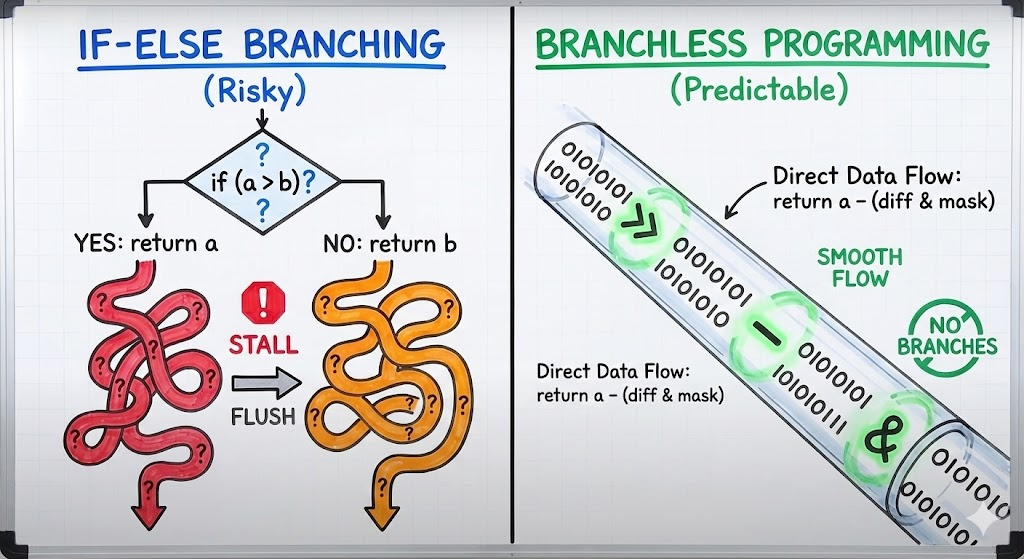
이 막대한 하드웨어 비용을 피하기 위해, 고성능 시스템(HFT, 게임 엔진, 커널)에서는 if문을 아예 제거하는 테크닉을 사용한다.
- Bad Case (분기 예측 의존):
// 데이터가 랜덤하다면 예측 실패 확률 50% -> Flush 반복
if (a > b) { return a; }
else { return b; }
- Good Case (Branchless):
// 순수 비트 연산으로 논리 구현 (예측 불필요 -> 파이프라인 풀가동)
// 원리: (a > b)가 참이면 mask는 -1 (1111...), 거짓이면 0 (0000...)
int diff = a - b;
int mask = (diff >> 31);
return a - (diff & mask);
이 코드는 하드웨어가 예측할 필요조차 없게 만든다. 이것이 진정한 최적화다.
3. 🤔 [Socratic Question] 소크라테스 질문: 파이프라인의 역설
이 지점에서 아키텍처 설계에 대한 본질적인 질문을 던져보자.
Q. "파이프라인을 잘게 쪼갤수록(깊게 만들수록) 클럭(GHz)을 높이기 쉽다고 했다. 그렇다면 파이프라인을 100단계, 200단계로 늘려서 10GHz, 20GHz짜리 슈퍼 CPU를 만들지 않는 이유는 무엇인가?"
.
.
.
A. (Insight)
이것이 바로 컴퓨터 구조 역사에서 유명한 '파이프라인의 역설(Pipeline Paradox)' 또는 '넷버스트(NetBurst)의 교훈'이다.
1. 리스크의 폭발: 파이프라인이 100단계라면, 예측 한 번 틀릴 때마다 100 사이클을 버려야 한다(Flush Penalty).
2. 한계 효용: 아무리 예측 알고리즘이 발전해도 100%는 불가능하다. 2~3%의 실패 때문에 치러야 할 비용이 너무 크면, 클럭이 아무리 빨라도 실제 처리 효율(IPC)은 바닥을 긴다.
3. 결론: 인텔은 과거 31단계까지 늘렸던 파이프라인을 포기하고, 현재는 적절한 깊이(14~19단계)를 유지하면서 '실패해도 복구 가능한 수준'의 고클럭을 추구하는 균형점을 찾았다.
4. 마무리: 개발자의 자세
우리는 하드웨어를 바꿀 수 없지만, 하드웨어를 돕는 코드를 짤 수는 있다.
- 정렬된 데이터(Sorted Data)를 사용하여 예측 가능성을 높여라.
- 다형성(Polymorphism)을 사용할 때는 호출 대상이 자주 바뀌지 않도록 주의하라.
- 성능이 극도로 중요한 루프 안에서는 분기를 줄이는 로직(Branchless)을 고민하라.
"Predictable Code is Fast Code." (예측 가능한 코드가 빠른 코드다.)