DAY 31: 개인 프로젝트 — model (2)
작업 일정
- #9 [model] 데이터 모델링
- #10 [model] 세션 기반 로컬 DB 설계 및 구현
- #11 [service] 세션 및 로컬 DB 관련
- #12 [service] 원격 DB 관련
#9 [model] 데이터 모델링
해 본 적 없는 작업이다 보니 AI의 도움을 좀 받았다. AI 초안을 보며 내 프로젝트에 맞게 변환하고 그걸 또 AI가 보고 개선할 부분을 제시하고, 내 의도와 다른 부분은 내 의도를 전달하고 차용할 부분은 차용하고. 수정된 코드를 AI가 다시 검토하고 하면서 몇 차례의 상호작용이 있었다.
AI로 딸깍 하는 거면 정말 금방 끝나지만 의사과정이 들어가면 최소 몇 시간에서 하루 정도는 잡아야 하는 것 같다. 경험이 있는 사람이었다면 처음부터 설계 요구사항을 명확히 전달해서 좀 더 수월했겠지만.
#10 [model] 세션 기반 로컬 DB 설계 및 구현
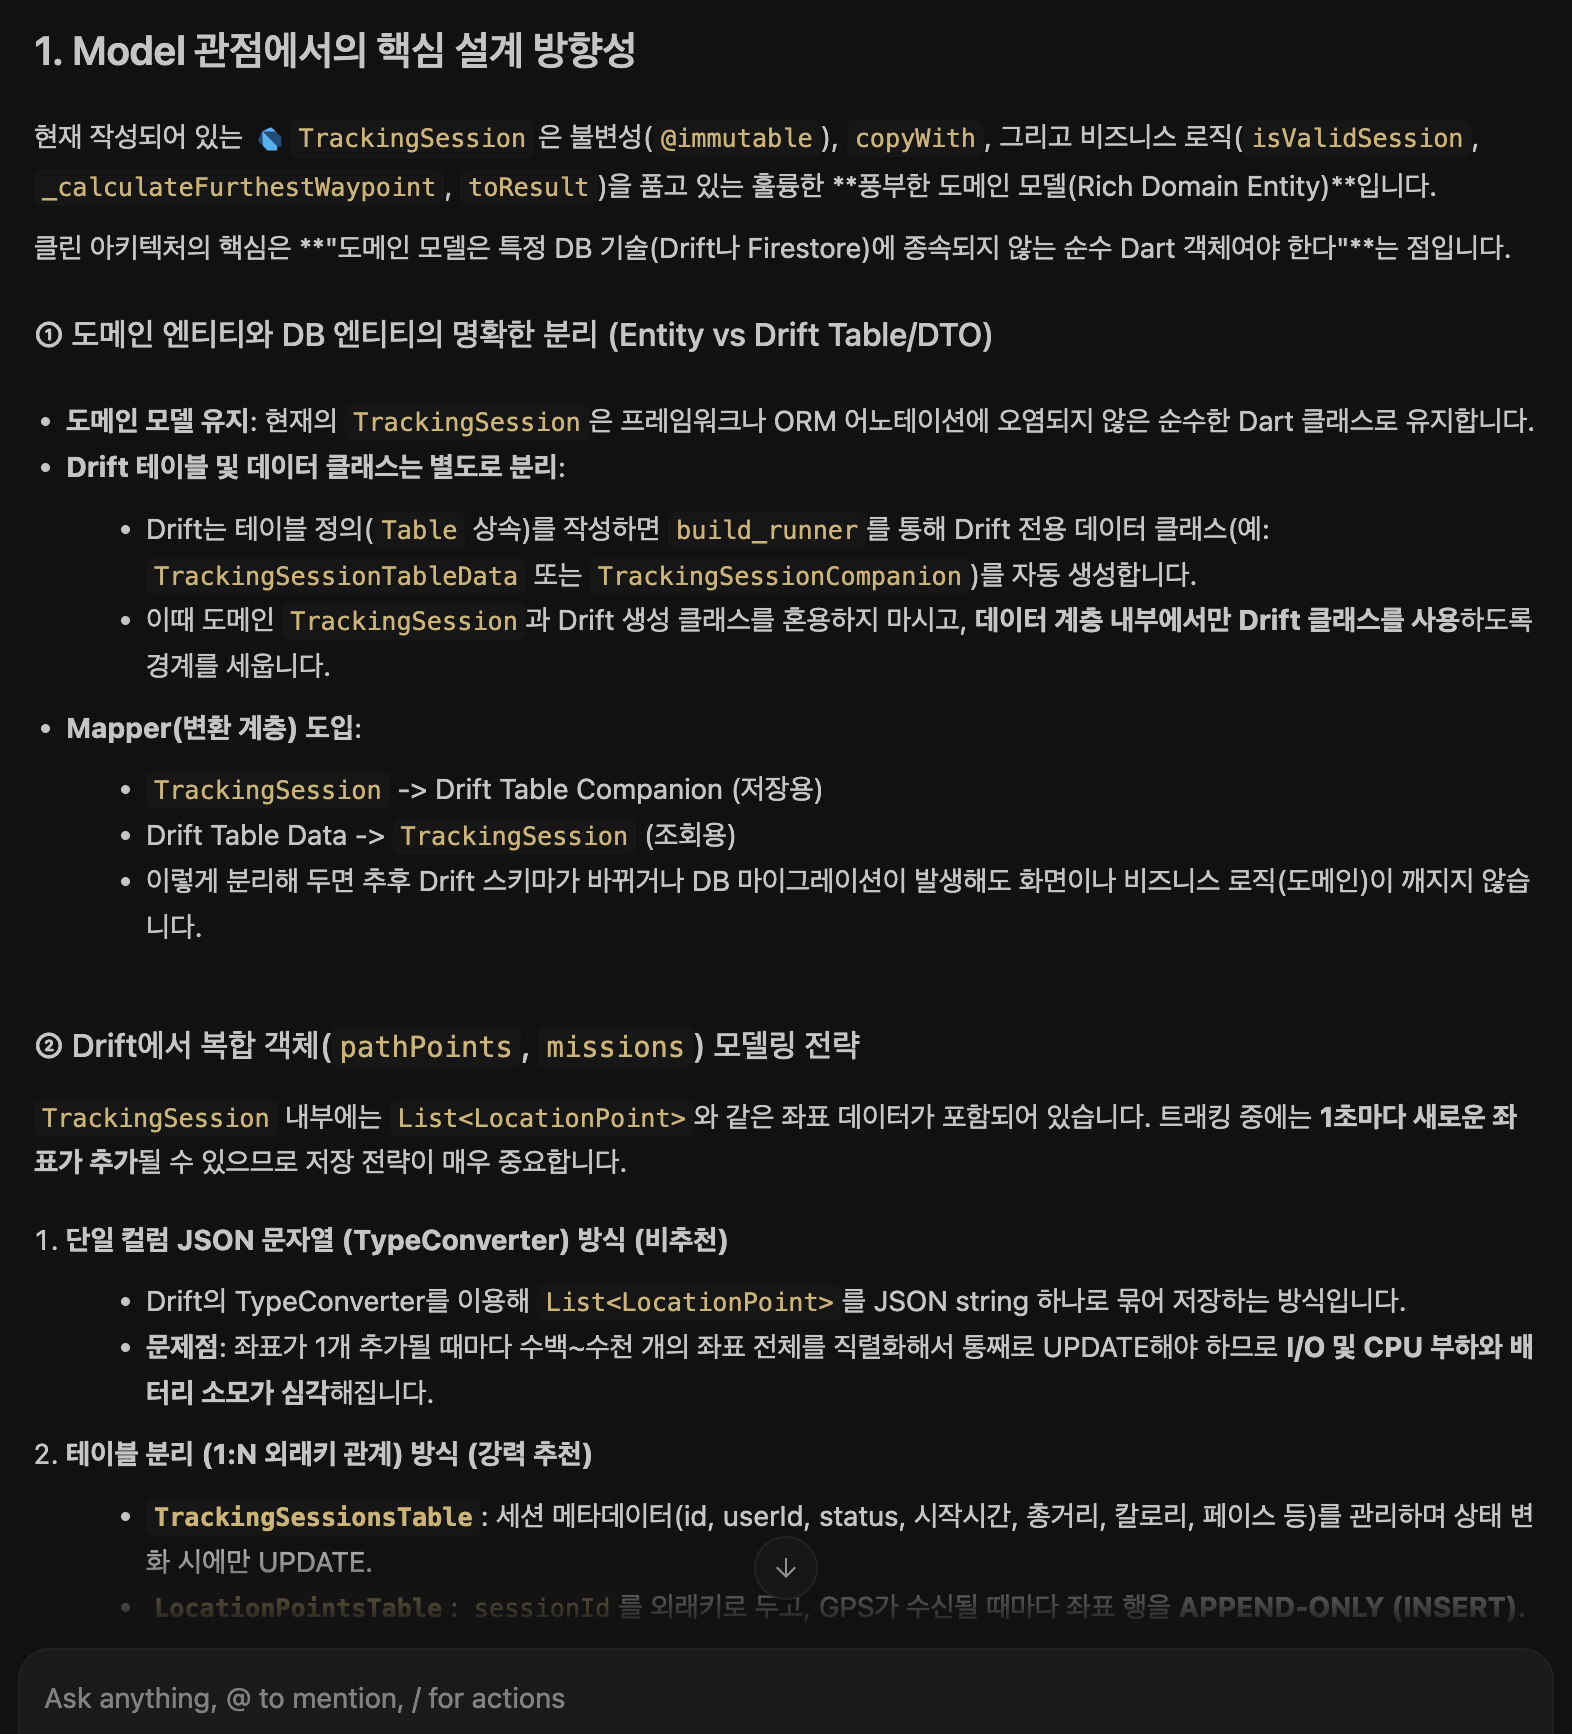
AI 응답 중 일부 발췌 | 로컬 DB 설계 시 고려할 점
Drift 공식 문서에 의하면 다음과 같은 dependecy들이 필요하다.
dependencies:
  drift: ^2.35.0
  drift_flutter: ^0.3.1
  path_provider: ^2.1.6

dev_dependencies:
  drift_dev: ^2.35.0
  build_runner: ^2.16.1
하지만 다음과 같은 오류가 나므로 build_runner: ^2.15.1 으로 변경하여 진행하도록 하겠다.
Resolving dependencies...
Note: meta is pinned to version 1.18.0 by flutter_test from the flutter SDK.
See https://dart.dev/go/sdk-version-pinning for details.

Because build_runner >=2.15.2 depends on analyzer >=13.3.0 <15.0.0 which depends on meta ^1.18.3, build_runner >=2.15.2 requires meta ^1.18.3.
And because every version of flutter_test from sdk depends on meta 1.18.0, build_runner >=2.15.2 is incompatible with flutter_test from sdk.
So, because move_sketch depends on both flutter_test from sdk and build_runner ^2.16.1, version solving failed.

You can try the following suggestion to make the pubspec resolve:
* Consider downgrading your constraint on build_runner: flutter pub add dev:build_runner:^2.15.1
Failed to update packages.
Process finished with exit code 1
[여담: 공식문서 내용과 AI의 가이드라인이 다르길래 물어보니...]
공식 문서를 아주 잘 확인하셨습니다! 공식 문서에 적힌 구성이 최신 Drift에서 권장하는 "가장 최신이자 정석 방식"이 맞습니다.
제가 처음에 안내해 드렸던 방식과 공식 문서의 방식 사이에 무엇이 달라졌는지, 그리고 왜 공식 문서의 방식이 훨씬 좋은지 핵심을 짚어드리겠습니다.
무엇이 다른가요? (
drift_flutter의 등장)과거의 Drift는 Flutter 전용 패키지가 따로 없어서, SQLite를 연결하려면 개발자가 직접 여러 패키지를 조합해야 했습니다:
- 과거 방식:
sqlite3_flutter_libs+path_provider+path패키지를 설치한 뒤,getApplicationDocumentsDirectory()로 파일 경로를 찾고,NativeDatabase.createInBackground(file)을 호출하는 등 10줄이 넘는 보일러플레이트 연결 코드를 직접 작성해야 했습니다.- 최신 공식 방식 (
drift_flutter): Drift 팀에서 Flutter 개발자를 위해 이 번거로운 연결 과정을 자동화한 전용 헬퍼 패키지인drift_flutter를 새롭게 출시했습니다.
공식 문서 방식(
drift_flutter)을 쓰면 코드가 어떻게 바뀌나요?이전의 복잡했던
_openConnection()함수가 단 한 줄로 줄어듭니다!기존 (과거 방식):
// 직접 파일 경로 찾고 백그라운드 스레드 열고... 번거로움
LazyDatabase _openConnection() {
  return LazyDatabase(() async {
    final dbFolder = await getApplicationDocumentsDirectory();
    final file = File(p.join(dbFolder.path, 'move_sketch.sqlite'));
    return NativeDatabase.createInBackground(file);
  });
}
최신 공식 방식 (
drift_flutter사용):import 'package:drift/drift.dart'; import 'package:drift_flutter/drift_flutter.dart'; // 헬퍼 import (tables: [...], daos: [...]) class AppDatabase extends _$AppDatabase { // driftDatabase(name: '...') 한 줄로 연결 끝! AppDatabase() : super(driftDatabase(name: 'move_sketch')); int get schemaVersion => 1; }
drift_flutter가 자동으로 해주는 일
- 저장 위치 자동 선정: Android, iOS, macOS 등 각 OS의 표준 문서 디렉터리를 알아서 찾아 안전하게 DB 파일을 생성합니다.
- 자동 백그라운드 실행(Isolate): DB 쿼리가 무거워져도 앱 UI(화면)가 버벅이지 않도록, 자동으로 백그라운드 스레드(Isolate)에서 DB 작업을 처리합니다.
- 의존성 간소화:
sqlite3_flutter_libs같은 플랫폼별 네이티브 바이너리 패키지를drift_flutter가 내부적으로 알아서 관리해 줍니다.따라서 사용자분께서 찾아보신 공식 문서의 의존성(
drift,drift_flutter,path_provider등)을 사용하시는 것이 훨씬 현대적이고 깔끔한 정답입니다!
무슨 차이인지 궁금해서 확인하며... Flutter 관련 자료를 찾아보면 버전 2 내용이 많이 섞여 있다거나 과거의 유산이 많이 보이며 특히 AI 답변은 과거인지 현재인지 구분하지 않고 섞어서 설명하는 경향이 있으니 주의하라는 말을 언젠가 강사님이 하신 적 있는데 새삼 실감했다.
#11 [service] 세션 및 로컬 DB 관련
스케줄을 짤 땐 설계가 마무리되기 전이라 대략 적어놓았는데 위치 정보도 결국엔 로컬 DB 관련에 포함되니 같이 가는 게 낫겠다. 사실 앞의 로컬 DB 설계도 service/repository로 넘어오기 전 model 단계에서는 따로 진행할 거 없이 issue#9에 통합되어도 무방한 영역이었다.
역시 프로젝트도 해봐야 전체적인 게 그려지는구나 싶다.
lib/services/local
다음과 같은 구조로 되어 있다.
lib/services/local/
├── app_database.dart
├── tables/
│   ├── tracking_sessions_table.dart
│   ├── location_points_table.dart
│   └── mission_instances_table.dart
├── daos/
│   └── session_dao.dart
└── mappers/
    └── session_mapper.dart
lib/services/local/tables/ 에 데이터베이스 스키마를 작성하고 이를 lib/services/local/app_database.dart 를 통해 등록한다. 데이터베이스에 대한 접근은 lib/services/local/dao/session_dao.dart 에서 관리한다. lib/services/local/matters/session_mapper.dart 에서는 이들을 하나의 domain으로 묶어준다.
데이터베이스 스키마를 작성하는 건 SQL을 다뤄본 적 있다면 누구나 쉽게 할 수 있을 것 같다. 문법만 Dart 문법일 뿐 형태는 익숙하다.
하라는 대로 했는데 테이블까지는 문제 없었지만 나머지 파일들은 작성 중 빨간 줄이 많이 보여서 뭐지 싶었다. 확인해 보니 Drift가 자동으로 만들어주는 것들을 아직 생성하지 않았기 때문에 그런 거라고 하더라. part 로 시작하는 줄은 반드시 파일명과 일치시켜야 한다고 하고.
터미널에서 다음 명령어를 사용하면 필요한 파일들이 자동 생성되어 빨간 줄이 사라진다.
dart run build_runner build
생성된 app_database.g.dart 에 파일 import와 관련된 에러가 뜬다면 app_database.g.dart 에 직접 넣어주지 말고(!) app_database.dart 에 추가해야 한다.
lib/repository/session
우선 abstract class를 lib/repositories/session/session_repository.dart 에 작성해 놓고, 실제 구현 작업은 Service를 전체적으로 마무리한 후에 하도록 하겠다.
lib/service/hardware
기기의 물리적 GPS 센서를 사용하기 위해 geolocator package가 필요하다. 버전은 ^14.0.3 로 넣어주겠다.
화면이 꺼져도 GPS가 끊기지 않아야 하므로 관련 권한을 주어야 한다. 안드로이드는 android/app/src/main/AndroidManifest.xml 에서 설정할 수 있다.
android/app/src/main/AndroidManifest.xml<manifest xmlns:android="http://schemas.android.com/apk/res/android"> <uses-permission android:name="android.permission.ACCESS_FINE_LOCATION" /> <uses-permission android:name="android.permission.ACCESS_COARSE_LOCATION" /> <uses-permission android:name="android.permission.FOREGROUND_SERVICE" /> <uses-permission android:name="android.permission.FOREGROUND_SERVICE_LOCATION" /> <uses-permission android:name="android.permission.WAKE_LOCK" /> <!-- 이하 생략 -->
iOS의 경우 Xcode를 열어 GUI로 설정할 수도 있고 ios/Runner/Info.plist 에 직접 작성해 주어도 된다.
ios/Runner/Info.plist<?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE plist PUBLIC "-//Apple//DTD PLIST 1.0//EN" "http://www.apple.com/DTDs/PropertyList-1.0.dtd"> <plist version="1.0"> <dict> <key>NSLocationWhenInUseUsageDescription</key> <string>조깅과 라이딩 경로 및 운동 거리를 측정하기 위해 위치 권한이 필요합니다.</string> <key>NSLocationAlwaysAndWhenInUseUsageDescription</key> <string>화면이 꺼진 상태에서도 운동 경로를 정확하게 기록하기 위해 백그라운드 위치 권한이 필요합니다.</string> <key>UIBackgroundModes</key> <array> <string>location</string> </array> <!-- 이하 생략 -->
lib/services/hardware/location_service.dart 에서는 위치 좌표를 적절히 변형하여 LocationPoint model의 형태로만 내보낸다. 정확도 오차가 너무 큰 경우 GPS 오차로 취급하여 필터링을 하기로 했다.
#12 [service] 원격 DB 관련
로컬 DB는 Drift를 사용했고 원격 DB는 Firebase를 사용할 것이다. 우리는 Firebase Auth, Firestore, Storage를 사용할 것이므로 이에 대한 pakcage를 각각 준비한다.
firebase_core: ^4.15.0
firebase_auth: ^6.7.0
cloud_firestore: ^6.10.0
firebase_storage: ^13.6.0
Firebase Auth
현재 로그인한 사용자가 누구인지를 다루는 영역이다. 로그인된 사용자를 식별하고, 회원가입과 로그인, 로그아웃을 담당한다.
소셜 로그인 버튼은 있지만 일단은 이메일로 로그인만 구현하고 소셜 로그인은 보류해 두겠다.
Firebase는 소셜 로그인이 아닌 자체 로그인을 이메일로 로그인만 지원하지만 나는 아이디로 로그인을 넣고 싶어서 이와 관련된 추가 작업을 했다. 아이디를 key로 하고 이메일과 메타데이터를 value로 갖는 account_ids/{id} 문서를 따로 저장해 놓고 가입 또는 로그인 시도하는 아이디로 GET 하여 (전체 목록이 아니라 해당 아이디에 대한 문서만 읽어온다) 문서의 존재 여부로 가입 여부를 판단하는 것이다.
가입할 때는 이 문서가 존재하지 않은 경우에만 허용해주며, 로그인 할 때도 이 문서를 확인해서 문서가 존재하는 경우에만 이메일 정보를 뽑아와서 내부적으로 이메일로 로그인을 시도한다.
아이디 뒤에 임의의 도메인을 붙여 가상의 이메일로 가입시키는 방법도 있지만 이메일 인증이 복잡해져서 아이디 문서를 따로 만드는 편이 더 낫다고 판단했다.
이로서 사용자 프로필에는 사용자가 선택해서 지은 가변적인 이름과 아이디만 노출될 뿐, 이메일은 시스템상으로만 존재하며 계정 관리에만 사용되도록 할 수 있다.
Cloud Firestore
스케치 이미지를 서버에 올리고 접근할 수 있는 URL을 return하는 녀석이다. 서버에 올려야 할 이미지는 사용자 프로필 이미지, 세션 종료 후 생성되는 스케치 이미지, 그리고 기록 탭에서 확인할 수 있는 해당 세션의 이동 경로 이미지 정도가 있겠다.
스케치 이미지나 이동 경로 이미지는 Session ID가 붙어서 상관 없지만, 프로필 이미지를 올릴 때 그냥 올릴 경우 파일 이름이 같을 경우 캐시 갱신과 관련된 버그가 있을 수 있다. 따라서 타임스탬프를 붙여 주도록 하겠다.
이미지 삭제는 deleteFileByUrl() 하나로 수행한다. 삭제 권한에 대한 검증은 Repository에서 1차로 수행하고, 서버에서 파일경로상의 userId와 삭제 요청자의 userId를 비교해서 2차로 수행할 것이다.
Firebase Storage
Firebase Storage와 관련된 Service는 lib/serivices/remote/firestore 디렉토리 내에 collection 별로 작성하기로 했다.
처음에는 특정 아이디가 사용 중인지 여부를 AuthService 에서 확인하여 가입 가능 여부를 판단하도록 작성했는데, 그렇게 하면 AuthService 가 두 가지 Firebase SDK에 종속되기도 하고, Repository에서 예외처리를 하기로 했던 만큼 의사결정 처리를 Repository에서 하는 게 적절한 것 같은데 Service단에 필요 이상의 의사결정 과정이 포함되더라. 그래서 사용 중인 아이디인지 여부는 UserService 에서 판단하고 AuthService 에서는 이메일로 로그인만 제공하며 이들을 조합하여 아이디로 로그인을 구현하는 건 AuthRepository 에서 하기로 했다.
피드 게시물 읽어오는 게 생각보다 복잡했다. 내 프로젝트에서는 모든 게시물이 친구 공개인데, 친구 목록에 있는 사용자가 작성한 글만 읽어오려 했더니 Firestore의 whereIn 연산자는 한 번에 30개의 ID까지만 지원한다.
AI에게 조언을 구하니 친구가 30명 이하일 경우와 30명을 초과할 경우를 나누어 로직을 구성하라고 하더라. 개인 운동 기록 앱이기 때무에 친구 수가 엄청나게 많은 경우게 edge-case일 것이니 항상 30명을 초과할 것을 상정할 필요가 없다고.
30명을 넘어설 경우에는 Future.wait() 을 통해 청크 분할 병렬 쿼리를 수행할 것을 추천하더라. 페이지네이션에 따라 limit만큼씩 불러와서 처리하고 결과 목록을 다시 limit만큼 자르라고 하길래 그러면 자른 만큼 읽기 토큰이 낭비되는 거 아니냐고 물어 보았다. 필요 이상으로 많은 걸 한 번에 읽으려고 하면 로딩 속도도 느리고 토큰 낭비도 될 수 있기 때문에 limit을 두고 페이지네이션을 하는 건데 이왕 읽어온 걸 칼 같이 자르면 좀 주객전도 같다고 느껴졌다. 그런 경우에는 캐싱을 해도 되고 그냥 다 return 해줘도 괜찮다고 응답 받았다. 나는 캐싱을 하는 건 살짝 오버엔지니어링인 것 같고, 다 return하기로 했다.
댓글을 적절한 순서로 불러오는 것도 좀 난해했는데, 이것도 결국 AI의 도움을 받았다. 시간 순서대로 하면 답글이 제대로 된 위치에 달리지 않을 수 있는 이슈였다. 내 프로젝트에서는 댓글의 답글의 답글 같은 건 없고 부모 아니면 자식의 두 계층만 있는데, 이를 활용하여 댓글(부모)과 답글(자식)을 나눴다.
시간 순으로 가져온 댓글 목록에서 부모를 따로 List에 담고 자식도 <부모ID,자식리스트>로 담아서 마지막에 부모를 최종 댓글 목록에 넣으며 사이사이에 자식을 끼워넣는 방식이다.
lib/services/remote/firestore/sketch_post_service.dart// 앞 부분 생략 final parentComments = <Comment>[]; final repliesByParentId = <String, List<Comment>>{}; for (final comment in comments) { if (comment.parentCommentId == null || comment.parentCommentId!.isEmpty) { parentComments.add(comment); } else { repliesByParentId .putIfAbsent(comment.parentCommentId!, () => []) .add(comment); } } final organized = <Comment>[]; for (final parent in parentComments) { organized.add(parent); if (repliesByParentId.containsKey(parent.id)) { organized.addAll(repliesByParentId[parent.id]!); } } // 뒷 부분 생략
Service를 구현하다 보니 Model의 결함도 종종 발견되어 함께 수정해 주었다. 그리고 아키텍처를 한 번 리팩토링 해줘야 할 것 같은데. Service 구현 마무리하고 Repository 넘어가기 전에 처리해 주기로 했다.