9장. 웹 크롤러 설계
- 웹 크롤러
- robot, spider
- 검색 엔진에서 널리 쓰는 기술
- 웹에 새로 올라오거나 갱신된 콘텐츠를 찾아내는 것이 주된 목적
- 몇 개 웹 페이지에서 시작해서 링크를 따라 나가면서 새로운 콘텐츠를 수집
- 크롤러 이용
- 검색 엔진 인덱싱
- 검색 엔진을 위한 local index 생성
- ex.
Googlebot: 구글 검색 엔진이 사용하는 웹 크롤러
- 웹 아카이빙 web archiving
- 나중에 사용할 목적으로 장기보관하기 위해 웹에서 정보를 모으는 절차
- ex. 미국 국회 도서관, EU 웹 아카이브
- web mining
- 웹의 폭발적 성장세 =
data mining업계에 굳 - 인터넷에 유용한 지식을 도출 가능
- ex. 기업의 핵심 사업 방향 알아내기
- 웹의 폭발적 성장세 =
- web monitoring
- 인터넷에서 저작권이나 상표권이 침해되는 사례 모니터링
- ex.
Digimarc(디지마크): 웹 크롤러를 통해 해적판 저작물을 찾아내서 보고
- 검색 엔진 인덱싱
1. 1단계 문제 이해 및 설계 범위 확정
웹 크롤러의 기본 알고리즘
- URL 집합이 입력으로 주어지면, 해당 URL들이 가리키는 모든 웹 페이지를 다운로드
- 다운받은 웹 페이지에서 URL들을 추출
- 추출된 URL들을 다운로드할 URL 목록에 추가하고 위의 과정을 반복
웹 크롤러 설계 요구 사항 분석
- 크롤러의 주된 용도는? 검색 엔진 인덱스 생성용? 데이터 마이닝? 이 외 다른 용도?
→ 검색 엔진 인덱싱 - 매달 얼마나 많은 웹 페이지를 수집?
→ 10억 개 - 새로 만들어진 웹 페이지나 수정된 웹 페이지도 고려?
→ yes - 수집한 웹 페이지 저장 필요?
→ 5년간 - 중복된 콘텐츠는 어떻게?
→ 무시
좋은 웹 크롤러가 만족해야하는 속성
- 규모 확장성
- 수십업 개의 페이지가 존재
- 병행성(parallelism)을 활용하면 보다 효과적으로 웹 크롤링 가능
- 안정성
robustness- 웹은 함정으로 가득
- ex. 잘못 작성된 HTML, 아무 반응이 없는 서버, 악성 코드가 붙어 있는 링크
- 이런 비정상적 입력이나 환경에 잘 대응할 수 있어야 함.
- 예절
politeness- 수집 대상 웹 사이트에 짧은 시간동안 너무 많은 요청을 보내면 X
- 확장성
extensibility- 새로운 형태의 콘텐츠를 지원하기 쉬워야 함
- ex. 이미지 파일도 크롤링하고 싶다고 할 때 전체 시스템을 새로 설계해야 한다면 곤란.
개략적 규모 추정
- 매달 10억 개의 웹 페이지 다운로드
- QPS = 10억 / 30일 / 24시간 / 3600초 := 400페이지 / 초
- 최대 Peak QPS = 2 * QPS = 800
- 웹 페이지 평균 크기 500k라고 가정
- 10억 페이지 x 500k = 500TB/월
- 1개월치 데이터 보관 500TB → 5년간 보관 500TB 12개월 5년 = 30PB
2. 2단계 개략적 설계안 제시 및 동의 구하기
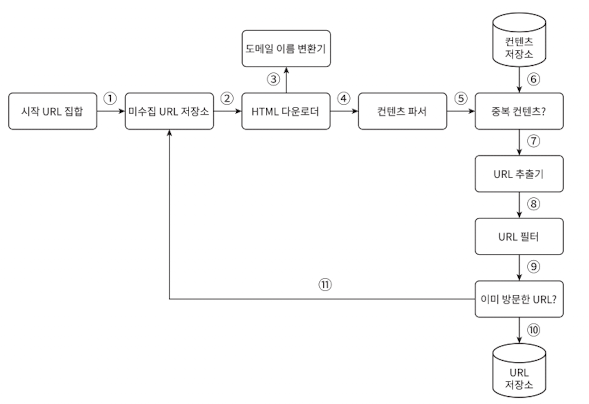
시작 URL 집합
- 웹 크롤러가 크롤링을 시작하는 출발점
- 크롤러가 가능한 한 많은 링크를 탐색할 수 있도록 하는 URL을 고르는 것이 바람직
- 방법1. 전체 URL 공간을 작은 부분집합으로 나누는 전략을 사용
- 방법2. 주제별로 다른 시작 URL을 사용 (주제별로 세분화, 각각에 다른 시작 URL을 사용)
미수집 URL 저장소
- 크롤링 상태
- 다운로드할 URL
- 다운로드된 URL
- 미수집 URL 저장소(
URL frontier) = 다운로드할 URL을 저장 관리하는 컴포넌트 - FIFO Queue
HTML 다운로더
- 인터넷에서 웹 페이지를 다운로드하는 컴포넌트
- 다운로드할 페이지의 URL은 미수집 URL 저장소가 제공
도메인 이름 변환기
- 웹 페이지를 다운받으려면 URL을 IP주소로 변환하는 절차가 필요
- HTML 다운로더는 도메인 이름 변환기 사용해서 IP 주소 알아냄
콘텐츠 파서
- 웹 페이지를 다운로드하면 parsing과 validation 절차가 필요
- 이상한 웹 페이지는 문제를 일으킬 수 있고 저장 공간만 낭비하게 되기 때문
- 크롤링 서버 내에 콘텐츠 파서를 구현하면 크롤링 과정이 느려짐
→ 독립된 컴포넌트 생성
중복 콘텐츠인가?
- 29% 가량의 웹 페이지 콘텐츠는 중복
- 데이터 중복 ⬇️, 데이터 처리 소요시간 ⬇️
- 두 HTML 문서 비교 방법
- 문자열 비교: 문서 수가 10억에 달하는 경우 비효율적 → 적용 곤란
- 효과적인 방법: 웹페이지의 해시 값 비교
콘텐츠 저장소
- HTML 문서를 보관하는 시스템
- 저장소를 구현하는 데 쓰일 기술
- 고려 요소: 저장할 데이터 유형, 크기, 저장소 접근 빈도, 데이터 유효 기간
- ex. 디스크와 메모리를 동시에 사용하는 저장소
- 데이터양 ⬆️ : 대부분의 콘텐츠는 디스크에 저장
- 인기있는 콘텐츠: 메모리에 → 접근 지연시간 ⬇️
URL 추출기
- HTML 페이지를 파싱하여 링크들을 골라내는 역할
- 상대경로 → 절대 경로로 변환
URL 필터
- 특정한 콘텐츠 타입이나 파일 확장자를 갖는 URL
- 접속 시 오류가 발생하는 URL, 접근 제외 목록에 포함된 URL등을 크롤링 대상에서 배제하는 역할
이미 방문한 URL?
- 이미 방문한 URL 이나 미수집 URL 저장소에 보관된 URL을 추적할 수 있도록 하는 자료구조를 사용
- 이미 방문한 적 있는 URL인지 추적
- 같은 URL을 여러 번 처리하는 일을 방지
- 서버 부하 ⬇️, 무한 루프 방지
- bloom filter, hash table
URL 저장소
- 이미 방문한 URL을 보관하는 저장소
웹 크롤러 작업 흐름
- 시작 URL들을
미수집 URL 저장소에 저장 HTML 다운로더: 미수집 URL 저장소에서 URL 목록 가져옴- HTML 다운로더:
도메인 이름 변환기를 사용하여 URL의 IP주소를 알아냄
→ 해당 IP 주소로 접속하여웹 페이지 다운로드 콘텐츠 파서: 다운된 HTML 페이지를 파싱하여 올바른 형식을 갖춘 페이지인지 검증- 콘텐츠 파싱과 검증이 끝나면
중복 콘텐츠인지 확인하는 절차 개시 - 중복 콘텐츠인지 확인하기 위해 해당 페이지가
이미 저장소에 있는지 확인
- 이미 저장소에 있는 콘텐츠인 경우: 처리 X, 버림
- 없는 경우: 저장소에 저장한 뒤 URL 추출기로 전달
URL 추출기: 해당 HTML 페이지에서 링크를 골라냄- 골라낸 링크를
URL 필터로 전달 - 필터링이 끝나고 남은 URL만
중복 URL 판별 단계로 전달 - 이미 처리한 URL인지 확인하기 위해, URL 저장소에 보관된 URL인지 확인
- 이미 저장소에 있는 URL 버림
- 저장소에 없는 URL: URL 저장소에 저장할 뿐 아니라 미수집 URL 저장소에도 전달
3. 3단계 상세 설계
DFS vs. BFS
- 웹 = directed graph
- page = node
- 하이퍼링크(URL) = edge
- 크롤링 프로세스 = 유향 그래프를 에지를 따라 탐색하는 과정
- DFS: 깊이 우선 탐색법
- 좋은 선택이 아닐 가능성 ⬆️
- 그래프 크기가 클 경우 어느 정도로 깊숙이 가게 될지 가늠하기 어려움
- BFS: 너비 우선 탐색
- 웹 크롤러가 보통 사용하는 탐색 방법
- FIFO 큐를 사용하는 알고리즘
- BFS의 문제점
- 한 페이지에서 나오는 링크의 상당수는 같은 서버로 되돌아감
- 결국 크롤러는 같은 호스트에 속한 많은 링크를 다운받느라 바빠짐
- 링크를 병렬로 처리하니까 해당 서버는 수많은 요청으로 과부하
→ impolite 크롤러로 간주 (때로는 Dos 공격으로 간주)
- 표준적 BFS 알고리즘은 URL 간에 우선순위를 두지 않음
- 처리 순서에 있어 모든 페이지를 공평하게 대우
- but, 모든 웹 페이지가 같은 수준의 품질, 같은 수준의 중요성을 갖지 X
- page rank, 사용자 트래픽 양, 업데이트 빈도 등 여러 가지 척도에 비추어 처리 우선순위를 구별하는 것이 온당
- 한 페이지에서 나오는 링크의 상당수는 같은 서버로 되돌아감
미수집 URL 저장소
- 미수집 URL 저장소를 활용하면 위 문제를 쉽게 해결 가능
- politeness를 갖춘 크롤러,
- URL 사이의 우선순위와 신선도를 구별하는 크롤러를 구현 가능
- URL 저장소: 다운로드할 URL을 보관하는 장소
- 예의 바른 크롤러
- 동일 웹 사이트에 대해서는 한 번에 한 페이지만 요청!
- 같은 웹 사이드의 페이지 다운 시 시간차 두고 실행
- 웹 사이드의 hostname과 다운로드를 수행하는 worker thread 사이의 관계를 유지
- worker thread 는 별로 FIFO 큐 가지고 있어서 해당 큐에서 꺼낸 URL만 다운로드
- queue router: 같은 호스트에 속한 URL은 언제나 같은 queue로 가도록 보장
- mapping table: 호스트 이름과 queue 사이의 관계를 보관하는 테이블
- FIFO queue: 같은 호스트에 속한 URL은 언제나 같은 큐에 보관
- queue selector: queue들을 순회하면서 queue에서 URL을 꺼내서 나온 URL을 다운로드하도록 지정된 worker thread에 전달
- worker thread: 전달된 URL을 다운로드. 순차 처리. 작업들 간 일정한 delay 두기.
- 우선순위
- 척도: PageRank, 트리팩 양, update frequency
- 순위결정장치(prioritizer)
- URL 우선순위를 정하는 컴포넌트
- URL을 입력으로 받아 우선순위를 계산
- queue: 우선순위별로 queue가 하나씩 할당됨
- 우선순위 ⬆️, 선택될 확률 ⬆️
- queue selector: 임의 queue에서 처리할 URL을 꺼내는 역할
- front queue: 우선순위 결정 과정 처리
- back queue: 크롤러가 예의 바르게 동작하도록 보증
- 신선도
freshness- 웹 페이지는 수시로 추가, 삭제, 변경
- 이미 다운로드한 페이지라고 해도 주기적으로 재수집(recrawl)
- but, 모든 URL을 재수집하는 것은 많은 시간과 자원이 필요
- 최적화하기 위한 전략
- 웹 페이지의 update history 활용
- 우선순위 활용하여 중요한 페이지는 좀 더 자주 재수집
- 미수집 URL 저장소를 위한 지속성 저장장치
- URL 수: 수억 개
- 모두 메모리에 보관: 안정성 ⬇️, 규모 확장성 ⬇️
- 모두 디스크에 보관: 속도 ⬇️ (병목지점)
- 절충안 (hybrid approach)
- 대부분의 URL은 디스크에,
- IO 비용 줄이기 위해 메모리 버퍼에 queue를 두는 것
- URL 수: 수억 개
HTML 다운로더
- HTTP 프로토콜을 통해 웹 페이지를 내려 받음
- Robots.txt
- 로봇 제외 프로토콜
- 웹 사이트가 크롤러와 소통하는 표준적 방법
- 크롤러가 수집해도 되는 페이지 목록이 들어 있음
→ 웹 사이트를 긁어 가기 전에 크롤러는 해당 파일에 나열된 규칙을 먼저 확인 - 주기적으로 다시 다운받아 캐시에 보관
- ex. https://www.amazon.com/robots.txt
User-agent: Googlebot
Disallow: /creatorhub/*
Disallow: rss/people/*/reviews
...
- 성능 최적화
- 분산 크롤링
- 크롤링 작업을 여러 서버에 분산
- 각 서버는 여러 스레드를 돌려 다운로드 작업을 처리
- URL 공간: 작은 단위로 분할하여 각 서버는 그 중 일부의 다운로드를 담당
- 도메인 이름 변환 결과 캐시
- 도메인 이름 변환기(DNS Resolver)는 병목 중 하나 (동기적 특성)
- 다른 스레드의 DNS 요청은 전부 block.
- DNS 조회 결과로 얻어진 도메인 이름과 IP 주소 사이의 관계를 캐시에 보관
→ cron job 등을 돌려 주기적으로 갱신
- 지역성
- 크롤링 작업을 수행하는 서버를 지역별로 분산하는 방법
- 크롤링 서버가 크롤링 대상 서버와 지역적으로 가까우면 페이지 다운로드 시간 ⬇️
locality를 활용하는 전략은 크롤 서버, 캐시, 큐, 저장소 등 대부분의 컴포넌트에 적용 가능
- 짧은 타임아웃
- 어떤 웹 서버는 응답이 느리거나 아예 응답하지 않음.
- wait time이 길어지면 좋지 않으므로, 최대 얼마나 기다릴지를 미리 지정
- 서버가 응답하지 않으면 해당 페이지 다운로드 중단 후 다음 페이지로 넘어감
- 안정성
- 안정 해시
consistent hashing- 다운로더 서버들에 부하를 분산할 때 적용 가능한 기술
- 다운로더 서버를 쉽게 추가, 삭제 가능
- 크롤링 상태 및 수집 데이터 저장
- 장애가 발생한 경우에도 쉽게 복구할 수 있도록
- 크롤링 상태, 수집된 데이터를 지속적 저장장치에 기록해두는 것
- 저장된 데이터를 로딩하고 나면 중단되었던 크롤링을 쉽게 재시작 가능
- exception handling
- error가 발생해도 전체 시스템이 중단되는 일 없이 이어나갈 수 있어야 함
- data validation
- 시스템 오류를 방지하기 위한 중요 수단
- 안정 해시
- 확장성
- 새로운 형태의 콘텐츠를 쉽게 지원할 수 있도록
- 확장 모듈
- PNG 다운로더
- URL 추출기
- 웹 모니터: 웹을 모니터링하여 저작권이나 상표권이 침해되는 일을 막는 모듈
- 문제 있는 콘텐츠 감지 및 회피
- 중복, 의미 없는, 유해한 콘텐츠 어떻게 감지? 시스템으로부터 어떻게 차단?
- 중복 콘텐츠
- 해시, check-sum 사용
- 거미 덫 spider trap
- 무한 루프에 빠뜨리도록 설계한 웹 페이지
- ex. spidertrapexample.com/foo/bar/foo/bar/foo/bar...
→ URL의 최대 길이를 제한하면 회피 가능 - but, 가능한 모든 종류의 덫을 피할 수 있는 만능 해결책은 X
- 기이할 정도로 많은 웹 페이지를 가지고 있는 것이 일반적
- 보통은 수작업으로 URL 필터 목록에 추가
- 데이터 노이즈
- 거의 가치가 없는 콘텐츠
- ex. 광고, 스크립트 코드, 스팸 URL
- 제외 필요
4. 4단계 마무리
- 그 밖의 추가 논의
- 서버 측 렌더링 (server-side rendering)
- 대부분 JS, AJAX 등의 기술을 사용해 링크 즉석 생성 → 동적 생성되는 링크 X
- 서버 측 렌더링(dynamic rendering) 적용 시 동적 생성 링크 가능
- 원치 않는 페이지 필터링
- 스팸 방지 컴포넌트
- 품질이 조악하거나 스팸성인 페이지 필터링
- 데이터베이스 다중화 및 샤딩
- 데이터 계층의 가용성, 규모 확장성, 안정성 ⬆️
- 수평적 규모 확장성
- 서버가 상태 정보를 유지하지 않도록 하는 것 = stateless 서버로 만드는 것이 중요
- 가용성, 일관성, 안정성
- 데이터 분석 솔루션
숭실대학교 컴퓨터학부 21