Intro
- 페이징은 프로세스를
물리적으로일정한 크기로 나눠 메모리에 할당하는 기법 - 세그멘테이션은 프로세스를
논리적 내용을 기반으로나눠 메모리에 배치하는 기법
세그멘테이션
- 세그멘테이션은 프로세스를
세그먼트(Segment)의 집합으로 만들며, 각 세그먼트의 크기는 일반적으로 같지 않다.- 프로세스를 code + data + heap + stack 으로 나눈 것도 세그멘테이션이라고 볼 수 있다.
- 각각 내부에서 더 작은 Segment로 나눌 수 있다.
- 프로세스를 code + data + heap + stack 으로 나눈 것도 세그멘테이션이라고 볼 수 있다.
- 세그먼트를 메모리에 할당할 때는 페이지를 할당하는 과정과 동일하다.
하지만 테이블의 형태는 다르다- 세그멘테이션을 위한 테이블은
세그먼트 테이블(Segment Table)이라고 한다. - 세그먼트 테이블은
세그먼트 번호와시작 주소(base),세그먼트 크기(limit 혹은 offset)를 Entry로 갖는다.- 구현의 간결함을 위해 세그먼트는 이름 대신 세그먼트 번호(Segment Number)로 구별된다.
- 세그멘테이션을 위한 테이블은
- 세그멘테이션의 주소변환은 페이징과 유사하다.
- 한 가지 주의할 점은 세그먼트는 크기가 일정하지 않기 때문에 테이블에 limit 정보가 주어진다는 것
- CPU에서 해당 세그먼트 크기를 넘어서는 주소가 들어오면 인터럽트가 발생하고 해당 프로세스를 강제로 중단시킨다.
세그먼트 주소 변환 예제
- 사용자 프로그램이 컴파일된 후 컴파일러는 자동으로 프로그램에 대한 세그먼트를 만든다.
- 예시 그림
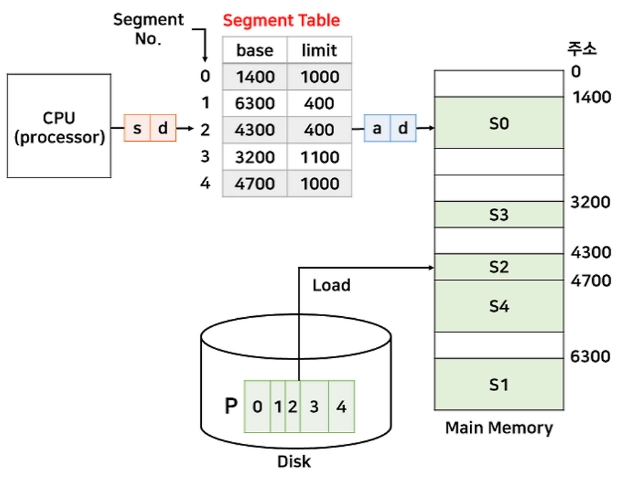
- 위 그림은 세그먼트 테이블과 프로세스가 할당된 메모리의 모습이다.
- 페이징 주소 변환과 동일하게 d는 논리주소와 물리주소가 동일하다.
- 물리 주소 a는 base[s] + d로 계산된다.
-> 언뜻 보면 2차원 주소로 보이지만, 메모리는 1차원이기 때문에 주소를 변환- 논리 주소 (2,100) -> 물리 주소 4400번지 (4300+100)
- 논리 주소 (1,500) -> 인터럽트로 인해 강제 종료(segment 1의 limit은 400)
- 즉, d는 반드시
0~ segment limit 사이의 값이여야 한다.
세그멘테이션에서 보호와 공유
- 세그멘테이션은 페이징이 제공하는 보호/공유 수준보다
더 효율적이라는 장점이 있다. - 보호에서는 세그멘테이션 역시 r, w, x 비트를 추가하는데,
세그멘테이션은 프로세스를논리적으로나누기 때문에 해당 비트를 설정하기 매우간단하고 안전하다.- 페이징은 주소 공간(code+data+heap+stack) 영역이 있을 때 이를 일정한 크기로 나눈다.
(내부 논리적 분류에 따라 나누는 것이 아님)
-> 두 영역이 섞일 수 있다. 이 경우 비트 설정하기 매우까다롭다.
- 페이징은 주소 공간(code+data+heap+stack) 영역이 있을 때 이를 일정한 크기로 나눈다.
- 공유에서도 마찬가지, 페이징에서는 code 영역을 나눈다고 해도
다른 영역이 포함될 확률이 매우 높다.- 하지만 세그멘테이션은 논리적 내용을 기반으로 정확히 code영역을 나눌 수 있기 때문에
더 효율적인 공유를 수행할 수 있다.
- 하지만 세그멘테이션은 논리적 내용을 기반으로 정확히 code영역을 나눌 수 있기 때문에
세그멘테이션 vs 페이징
- 세그멘테이션은 페이징과 유사하면서도 보호와 공유에서 더 나은 성능을 보임을 언급했다.
- 하지만 현재
대부분은 페이징 기법을 사용한다. 세그멘테이션에는치명적인 단점이 있기 때문이다.
세그멘테이션의 외부단편화 문제
-
외부 단편화
세그멘테이션은일정한 크기가 아니라논리적 내용에 따라 메모리를 분리하기 때문에 각 세그먼트의 크기가 다양하다.
이로 인해여러 크기의 hole이 발생한다는 것이다.hole : 프로세스 사이에 할당되지 않은 메모리 공간
-
어느 hole에 프로세스를 할당할 지를 완전히 해결하는 알고리즘이 존재하지 않고, 따라서
외부 단편화로 인해 메모리 낭비가 발생한다.
페이징의 내부단편화 문제
-
페이징도
내부 단편화라는 문제가 존재한다. -
내부 단편화
프로세스의 크기가페이지 크기보다작을 때차이만큼 메모리가 남지만 해당 메모리를 다른 프로세스가 사용할 수 없는 문제. -
그럼에도 페이징을 사용하는 이유
내부 단편화로 낭비되는 공간보다외부 단편화로 낭비되는 공간이 훨씬 크고,모든 공간의 크기가 동일해 OS 입장에서 메모리 할당 해제가 훨씬 단순하고 효율적이다.
결론
- 결론적으로 세그멘테이션은
보호와 공유에서 효율적이지만, 외부 단편화를완전히 해결할 수 있는 알고리즘이아직 발견되지 않아
페이징이 주로 사용된다.
-> 장점을 활용하기 위해 페이징을 혼용하는Paged Segmentation이라는 개념도 존재한다.
Paged Segmentation
: 세그먼트를 페이징 기법으로 나누는 것
-> 프로세스를 여러 개의 논리적 세그먼트로 나누고, 각 세그먼트가다시 고정된 크기의 페이지들로 분할되어 물리 메모리에 저장
- 단점
먼저 세그먼트 테이블에 접근하고, 그 후 해당 세그먼트의 페이지 테이블로 접근해야 물리 주소를 알 수 있다.
(따라서 논리 주소는 세그먼트 번호, 페이지 번호, 페이지 크기 총 3가지의 데이터로 구성되어 있다.)
-> 변환 과정이 두 번 필요하기에복잡성을 증가시키고,메모리 접근 지연(Latency)을 야기할 수 있다.
정리
| 구분 | 세그멘테이션 | 페이징 | 페이지화 세그멘테이션 |
|---|---|---|---|
| 분할 단위 | 가변 크기(논리적 의미) | 고정 크기(기계적 분할) | 논리적 분할 후 다시 기계적 분할 |
| 단편화 문제 | 외부 단편화 발생 | 내부 단편화 발생(미미함) | 내부 단편화 발생 가능 |
| 장점 | 보호/공유가 매우 쉬움 | 메모리 관리 효율성 극대화 | 두 방식의 장점을 모두 취함 |
| 단점 | 복잡한 메모리 배치 알고리즘 | 보호/공유 설정이 까다로움 | 주소 변환이 2단계라 느리다. |
레퍼런스
코딩 창고!