1. 개요
결론적으로 말하면, Docker Swarm란 여러 컨테이너 혹은 그러한 컨테이너를 관리하는 매니징 체계(보통은, Host Docker 및 이를 관리하는 PC)를 클러스터로 그룹화하여 간편하게 다룰 수 있는 환경을 의미한다.
이 의미를 자세히 살펴보면 꽤나 비슷한 하나의 무엇인가가 생각이 나는데, 바로 쿠버네티스이다.
쿠버네티스는 널리 알려진 컨테이너 오케스트레이션의 일종으로, 컨테이너의 실행을 넘어 이러한 다수의 컨테이너 배포 및 운영까지 자동화하고 간편함까지 획득하고자 하는 목적으로 사용하는 도구이다.
사실 도구라고 하기에는, 운영 및 관리의 자동화와 복구, 무중단 배포 등 인프라에서 필수적인 요소들을 간편하게 관리할 수 있도록 다양한 기능을 제공하는 운영체제라 볼 수 있겠다.
현대 인프라에서 쿠버네티스는 매우 중요하다. 사람이 할 수 없는 빈틈을 쿠버네티스가 간편하게 관리해줄 수 있기 때문이다. 하지만 그에 반해 Docker Swarm은 성능과 규모적인 관점에서 쿠버네티스를 대체할 수 없다. 어느 곳에서도 쿠버네티스 대신 사용하지 않을 것이다.
하지만 쿠버네티스를 이해하기 위해서는 컨테이너와 컨테이너 클러스터링 등 그 세부적인 요소들을 먼저 다뤄보고 파악할 수 있는 Docker Swarm를 먼저 살펴보는 것이 매우 큰 도움이 될 것이다.
그리고, 실무에서 사용하지는 않을지라도 쿠버네티스를 사용할 수 없을때, 이에 대한 대체재로 Docker Swarm을 충분히 고려하여 도입할 수 있을 것이며, 관점으로나 선택 요소로나 여러 측면에서 시야를 넓힐 수 있는 좋은 기회가 될 것으로 판단하여 Docker swarm을 한번 적용해보기로 하였다.
2. 쿠버네티스
Docker swarm의 종착점은 결국 쿠버네티스인데, 먼저 Docker Swarm의 큰 지향점을 바로보도록 하자.
Monolithic
전통적인 Monolithic의 시스템에서는 쿠버네티스의 필요성을 느낄 수 없었고, 실제로도 1개의 서버에 1개의 프로세스(WAS)를 구성하면 되었기에 사람이 배포, 실행하는데 큰 문제가 없었다.
서버
 └── Spring Application
java -jar app.jar위 도식과 cli처럼 직관적이다.
2WAS / 3WAS
트래픽이 증가함에 따라, 프로세스를 두개의 서버에서 운용하는 등 2WAS 혹은 3WAS의 체계가 등장하기 시작하였다.
서버1
 └── app

서버2
 └── app

서버3
 └── app
단일 WAS에서 서버를 배포할때처럼 다양한 서버에서 프로세스를 배포하고 실행하기 시작하였다.
Docker
이때 프로세스를 실행하기 위해 필요한 자원을 가상화하거나, 하드웨어 자원에 대해 실행환경을 격리하여 이미지화함으로써 프로그램 실행 과정을 간편화할 수 있게 되었다.
Docker Image
 ㄴ Spring Boot
 ㄴ JDK
 ㄴ Library
 ㄴ 설정
이러한 이미지를 실행하여 운영체제에 독립적인 프로세스를 운영할 수 있도록 컨테이너라는 실행 환경이 만들어졌고, 이에 따라 Docker가 만들어졌다.
다수의 컨테이너 운영
하나의 프로세스, 하나의 WAS를 운영하는데는 문제가 없다. 사람이 충분히 관리할만하다.
하지만 컨테이너의 배포, 재시작을 할때
docker run ..
docker stop ..
docker start ..
사람이 일일이 도커 명령어를 입력해주어야 하는 불편함이 생겼다.
나아가,
서버1 docker cli
서버2 docker cli
...
서버10 docker cli
각 서버마다 docker cli를 직접 입력해주어야 하며, 서버의 개수는 트래픽이 늘어날때마다 1대, 2대로 늘어나지 않고 수십대가 늘어나게 되어 Human Fault를 수용할 수 있는 수준을 넘어, 더이상 관리하기 불가능한 규모의 시스템 트래픽이 발생하게 된다.
Trouble Shooting
컨테이너 1대가 갑자기 멈추었을때, 단순히 멈춘 컨테이너를 다시 실행하는 것이 아닌, 해당 컨테이너의 본질적인 문제를 해결할때까지 다른 컨테이너를 대신 활용하여 실행해야 한다는 것을 의미하기도 한다.
또한, 다른 버전의 프로세스를 실행하기 위해 컨테이너를 만들어야 하는데, 이 과정에서 서비스 운영이 끊길 수도 있고, 이로 인한 서비스 공백이 생겨버린다.
Docker는 자원 격리를 통해 프로세스 실행을 간편화해주는 도구일뿐, 운영 관점에서 이를 간편화하고 자동화하는 기술(체제)는 아니다.
쿠버네티스의 도입 : 대규모 서비스의 간편한 운영 및 자동화
바로 이러한 문제를 해결하기 위해, 즉 대규모 서비스와 프로세스를 하나의 단위로 간편하게 운영하고 이를 자동화하기 위해 도입한 거대한 체계이자 운영체제가 바로 쿠버네티스이다.
도커가 자동차라면, 이러한 수십, 수백대의 자동차를 관리할 수 있는 관제센터가 바로 쿠버네티스인 것이다.
쿠버네티스는 기본적으로 사람이 관리할 수 없는 영역을 관리한다.
MSA는 대규모 트래픽을 대응해야 하는 상황에서, 각 도메인의 분리를 통해 트래픽을 DB 및 HTTP 차원에서 소분화하는 대응 체계이며, 기본적으로 대규모 트래픽을 대응하기 위해 도입한 분산 시스템이기에 이를 관리하기 위해서는 수많은 서버 및 자원을 관리해야 한다.
위에서 기술하였듯이, 이를 사람이 관리하는 것은 불가능하기에 쿠버네티스는 이러한 부분들을 관리할 수 있는 다양한 기능, 기술들을 제공하여 준다.
-
자동 복구(Self Healing)
사람의 경우 컨테이너가 죽으면 이에 따른 재실행 docker cli를 입력해주어야 하지만, 쿠버네티스의 경우 자동으로 회복한다. -
Auto Scaling 및 로드 밸런싱
기존에 설정한 Pod 및 컨테이너로 CPU사용률을 90%까지(임계치) 사용한 상태라면, 쿠버네티스는 이에 대해 Scaled Out을 진행하여 CPU 사용률을 낮추고 대규모 트래픽에 대응하기 위한 조치를 진행한다. 트래픽이 적어질경우 반대로 실행 Pod 및 컨테이너 숫자를 줄여 자원 사용량을 줄인다. -
무중단 실행
특정 노드의 서비스가 멈추었다고 하더라도, stand-by 혹은 cold한 다른 node를 대체 실행하여 서비스를 무중단 실행할 수 있도록 관리한다. -
배포 자동화 및 무중단 배포
전통적인 서비스 중단 및 새 버전의 프로세스 실행이 아닌, 카나리 배포 기반의 Rolling Update 등을 통해 사용자 입장에서 서비스를 계속 이용하면서도 새로운 버전의 프로세스를 점진적으로 이용할 수 있도록 무중단 배포 및 배포 자동화 기술을 제공할 수 있다.
이러한 목표를 달성하기 위해 쿠버네티스가 도입이 된 것이고, 그 전에 Docker Swarm을 통해 쿠버네티스의 대체재 및 핵심 동작 원리의 관점에서 쿠버네티스를 받아들일 수 있는 충분한 준비 과정을 진행할 것이다.
3. Docker Swarm(*cf. Docker Compose/Service/Stack)
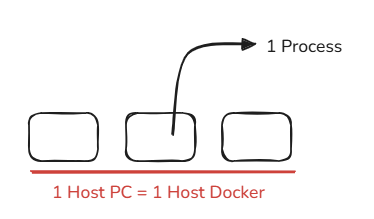
Docker Compose까지는 사실상 "프로세스 실행을 이미지화, 간편화한 것"이라는 도커의 전통적인 취지를 위한 기술이라 볼 수 있겠다.
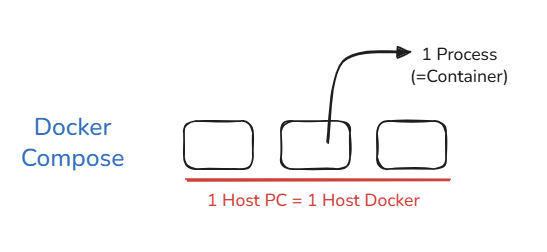
Host Docker(보통 1PC)에서 실행하는 다수의 컨테이너들을 하나의 이미지로 묶어, 단일 호스트에서 실행하는 실행 프로세스 자원을 간편하게 정의할 수 있다.
Docker Swarm
이러한 단일 호스트 Docker에서 관리하는 여러 컨테이너 및 실행 자원들을 묶는데, 이때 단순히 실행의 개념이 아닌 자원 관리 및 운영의 개념이 들어가기에 멀티 호스트의 클러스터링이란 단어를 사용한다.
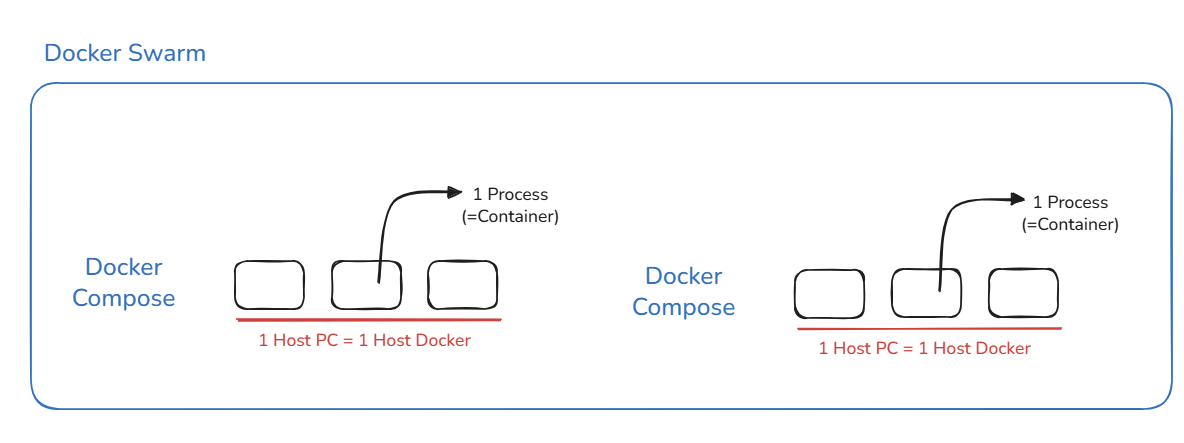
즉, Docker Swarm은 이러한 멀티 호스트의 분산된 컨테이너들을 하나의 클러스터로 묶고, 사람이 관리할 수 있도록 간편한 기능과 체계를 제공하는 기술이다. 바로 이러한 기술이 쿠버네티스의 본질과 많이 닮았다는 점에서 쿠버네티스를 이해하고 대체해서 사용하는데 상당히 큰 도움이 될 수 있다는 것이다.
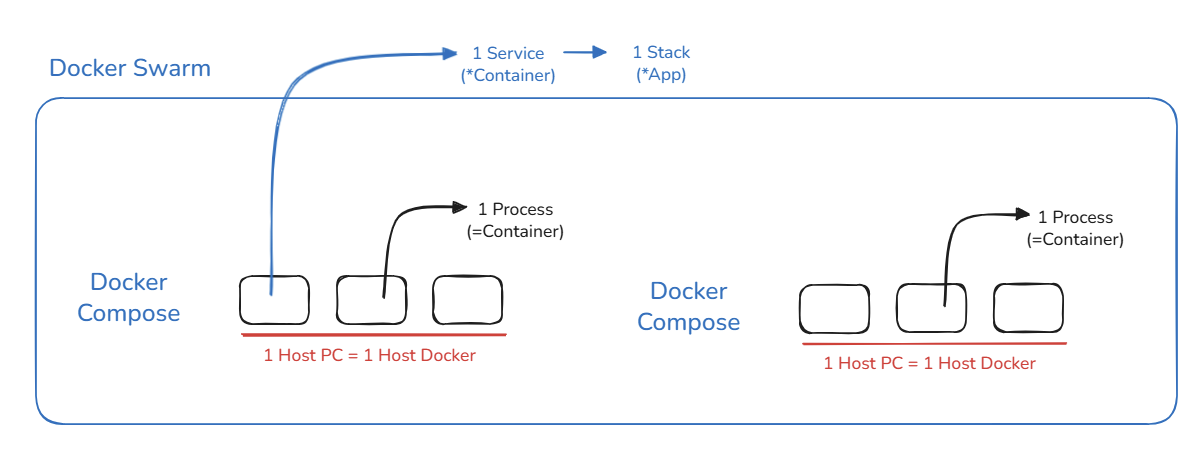
이때, Docker Swarm을 통해 관리하는 격리된 프로세스(컨테이너) 혹은 그 이상의 집합을 Service라 하며, 이러한 Service를 묶어 또 다른 하나의 집합이자 애플리케이션으로 관리하기 위한 영역(체계)을 Stack이라 일컫는다.
4. 멀티 호스트 환경 구축
Docker Swarm을 적용하기 위해선 본질적으로 접근할 필요가 있다.
MSA 환경과 Multi Module 환경은 언어, 도메인 등 본질적인 체계가 완전히 다른 진정한 이기종 환경이라는 점에서 차이가 크다. 마찬가지로, Docker Swarm의 목적은 기본적으로 멀티 호스트에서 운영하는 멀티 컨테이너들을 하나로 통합하기 위한 것이므로 이러한 취지에 맞게 멀티 호스트 환경을 구축해야 하는 것이 적절하겠다.
이에 대한 환경 구축 방안은 두가지가 있을 수 있는데, 인프라 관점에서 꽤 중요한 내용이기에 한번 깊게 다뤄보도록 하겠다.
4-1. Docker
Docker란 위에서 기술하였듯이, 실행 과정을 자원 격리 및 이미지화를 통해 단순화하고 간편화한 하나의 기술이다.
+-------------------------+
| Host OS                 |
|                         |
|  Docker CLI             |
|      │                  |
|      ▼                  |
|  Docker Engine(Daemon)  |
|      │                  |
|      ▼                  |
|  Container A            |
|  Container B            |
|  Container C            |
+-------------------------+
이를 실행하기 위해선 위와 같이, 기본적으로 실행 환경(컨테이너)을 구성하기 위한 도커 엔진, 즉 데몬이 필요하다. 이 데몬의 기점을 단일 Host PC 내부에서 시작할 것인지, 각기 다른 단일 Host PC에서 모두 다르게 시작할 것인지에 따라 컨테이너 환경 구축 설계가 달라진다.
바로 이 설계에서 DinD, DooD라는 개념을 적용할 수 있다. 참고로, 멀티 호스트 환경을 구축하기 위해 DinD, DooD 모두 사용가능하며, 본질적으로 모두 동일한 환경 구축 및 이에 대한 결과를 기대할 수 있다.
4-2. DinD(Docker in Docker)
말 그대로, 단일 호스트 PC의 도커엔진(데몬)에서 또 다른 운영체제 혹은 컨테이너를 실행할 도커 엔진 환경을 구축하는 것이다.
Host

+-------------------------------------------------------+
| Host Docker Engine                                    |
|                                                       |
|   +-----------------------------------------------+   |
|   | DinD Container                               |   |
|   |                                               |   |
|   |  Docker CLI                                  |   |
|   |      │                                       |   |
|   |      ▼                                       |   |
|   |  Docker Engine (새로운 daemon)               |   |
|   |      │                                       |   |
|   |      ▼                                       |   |
|   |  Container A                                 |   |
|   |  Container B                                 |   |
|   +-----------------------------------------------+   |
|                                                       |
+-------------------------------------------------------+
단일 Host의 데몬 기반에서 또 다른 도커엔진을 구축하고, 여기서 새로운 컨테이너를 구성할 수 있으며 Host의 데몬과는 완전히 독립적인 또 하나의 데몬으로 내부의 컨테이너들을 생성할 수 있다.
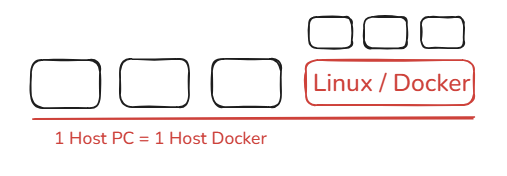
즉, Host 데몬에서 또 다른 데몬(도커엔진)을 구축하여, 이 위에 여러 컨테이너를 올려두고 또 다른 데몬(도커엔진)을 생성하여 마치 VM위에 다수의 운영체제를 실행하는 것과 같은 멀티 호스트 체제를 구축할 수 있는 것이다.
Host 측에서는 이러한 dockered를 모른다. DinD 내부의 도커가 관리하기에, 마치 여러 PC가 컨테이너를 실행하는 효과를 기대할 수 있게 된다.
4-3. DooD(Docker out of Docker)
이와 다르게, 단일 Host PC의 도커엔진(데몬)을 그대로 이용하는 방식이 바로 DooD이다.
+----------------------------------------------------+
| Host                                               |
|                                                    |
| Docker Engine                                      |
|     ▲                                              |
|     │                                              |
| docker.sock                                        |
|     ▲                                              |
|     │                                              |
| +---------------------------+                      |
| | Build Container           |                      |
| |                           |                      |
| | Docker CLI                |                      |
| +---------------------------+                      |
|                                                    |
+----------------------------------------------------+
컨테이너를 만들때 모든 컨테이너들은 호스트 PC, 데몬의 거버넌스를 받으며, 이에 따라 docker.sock을 통해 host 데몬의 권리/접근 방식에 영향을 주거나 받을 수 있게 된다(docker.sock 인터페이스를 마운트하여 컨테이너 내부에서 데몬 cli를 host 도커에게 그대로 전달 및 실행하게 되며, host는 이를 실행하여 host 기반의 또 다른 컨테이너를 생성하게 된다).
도커 안의 엔진이 없고 오로지 하나의 데몬만 존재하기에, 모든 도커 컨테이너에는 별도의 도커 엔진이 존재하지 않고 오직 docker cli 하나만 존재한다.
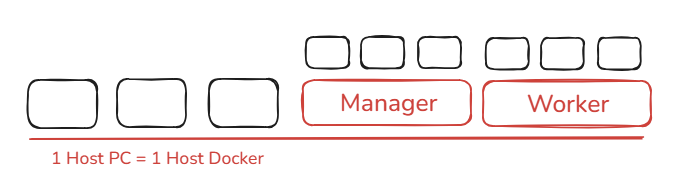
이 중, DinD를 활용하여 멀티 호스트에서의 멀티 컨테이너, 이를 클러스터링 한 Docker Swarm 환경을 구축해보고자 하며 이 모습은 위 그림과 같다(Manager Node / Worker Node로 이루어진 다수의 운영체제 환경).
4-4. 도커엔진 및 리눅스
도커를 실행하다는 것은 이미지 정보에서 얻은 실행 정보를 바탕으로 컨테이너를 실행한다는 의미인데, 이러한 컨테이너 실행 환경(도커 엔진)을 위해서는 반드시 리눅스 환경이 기반이 되어야 한다.
Linux
    ↑
Docker Engine
    ↑
Container
마찬가지로, DinD 도커엔진을 구성하여 이 위에서 Host 컨테이너(엔진) 환경을 구성하기 위해선 각각 리눅스 환경이 선제적으로 구성되어야 한다.
Host PC
    │
Windows
    │
WSL2(Ubuntu)
    │
Host Docker Engine
    │
DinD Container
    │
Linux
    │
Docker Engine
그런데 다행인 점은 dind 컨테이너 환경 자체, 리눅스 환경 그 자체를 지원하는 공식 이미지가 존재한다. 이 이미지는 내부적으로 리눅스 및 도커 CLI, 도커 엔진(Docker Daemon)이 모든 환경을 가지고 있기에, 우분투 이미지를 별도로 생성하고 도커 내부에 또 다른 도커 엔진을 설치하는 등의 번거로운 과정을 진행하지 않아도 된다.
Host Docker Engine

↓

Container(manager)

↓

Alpine Linux

↓

Docker Engine
이 DinD 환경을 여러개 구성한다면, 멀티 호스트, 즉 다수의 도커 엔진 환경에서 구동하는 멀티 엔진 및 컨테이너 환경을 구성할 수 있는 것이다.
물론 Host PC(데몬) 입장에서는 단순히 3개의 컨테이너를 실행하는 것과 다름이 없으나, Host 엔진이 띄운 3개의 격리된 컨테이너는 결국 3개의 DinD(도커엔진)을 실행하고 있는 것과 동일하다.
┌────────────────────────────────────┐
│ Host Docker Engine              │
└────────────────────────────────────┘
          │
 ┌────────┼───────────┐
 │        │           │
 ▼        ▼           ▼

manager  worker1   worker2
(Host 입장에서는 Container, 각 격리된 환경은 하나의 도커 엔진 환경)

각 컨테이너 내부

┌──────────────────┐
│ Alpine Linux    │
│                 │
│ dockerd         │ ← Docker Engine
│ docker CLI      │
└──────────────────┘
4-5. docker swarm을 위한 환경 구성
docker swarm 환경을 구성하기 위해서는 멀티 호스트 환경(DinD)을 먼저 구성해야 한다.
이를 위해, 각 격리된 Manager / Work 간의 네트워크 환경을 구축해주어야 한다.
DinD 이미지를 활용하기 위해 필요한 조건은 아니지만, swarm 환경에서 각 컨테이너들이 통신을 하기 위해 도커 네트워크가 반드시 필요하기 때문이다.
참고로,
swarm-net

manager → 172.xx.xx.2

worker1 → 172.xx.xx.3

worker2 → 172.xx.xx.4
네트워크를 통해 구성된 가상의 L2 네트워크 환경에서, Swarm의 매니저가 worker 노드로 패킷을 보낸다면 worker 노드가 그 패킷을 받고 swarm 전용의 네트워크 환경에서 안정적으로 통신을 주고받을 수 있다.
사실 기본적으로 제공하는 브릿지 네트워크(Host)로 통신이 가능하긴 하지만, 다른 목적의 컨테이너를 실행한 만큼 Host와 격리된, 동일한 목적의 컨테이너 간의 TCP 통신에만 신경쓸 수 있는 별도의 브릿지 네트워크 환경이 반드시 필요하겠다.
docker network create docker-swarm-network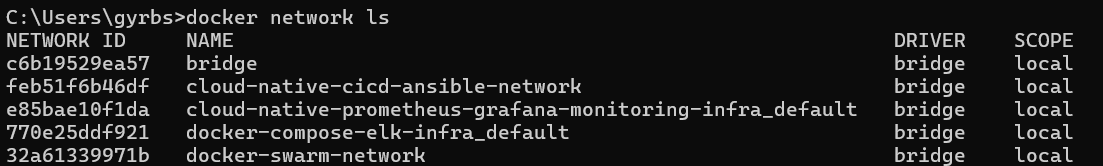
이제, 본격적으로 DinD 환경의 멀티 호스트 환경을 구성해보도록 한다.
docker run -d --privileged --name docker-swarm-manager --hostname manager --network docker-swarm-network docker:din
실제로 실행해보면 위와 같이 docker:dind 이미지가 공식적으로 존재하기에, 이를 pull받아 컨테이너 환경을 구성하는 것을 알 수 있고,

위와 같이 dind 이미지에서 실행하는 격리된 dind 도커 엔진 컨테이너를 실행할 수 있음을 알 수 있다.
참고로, --privileged를 통해 host docker의 리눅스 커널 명령(host 도커 엔진) 실행 권한을 확보하여 각 Dind 환경이 host docker의 권한을 전적으로 위임받아 컨테이너 삭제 및 재시작, 네트워크 재시작 등을 할 수 있도록 해주어야 한다.
이어서, worker 노드를 생성한다.
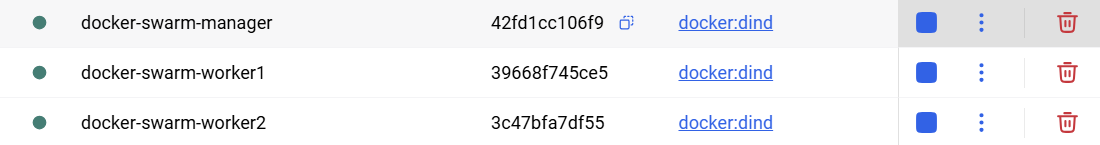
docker -ps를 통해 각 dind 환경이 잘 구성되어있는지 확인한다.
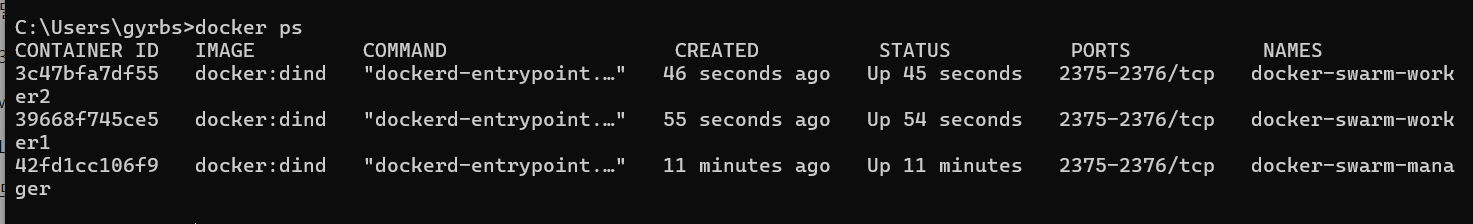
참고로 dind 이미지의 경우 본 swarm 환경 구성 간 편의상 latest로 진행하였으나, 28-dind와 같이 이미지 관리 현황을 어느정도는 인지하고 구성해주는 것이 좋겠다.
5. Swarm / Join
먼저, 각 노드들의 정상적인 실행 여부를 확인해야 한다. docker Swarm을 구성해주기 위해서는 각 노드들의 실행과 더불어, 각 노드들의 네트워크까지 정상적으로 이루어져야 하기 때문이다.
docker exec docker-swarm-manager docker info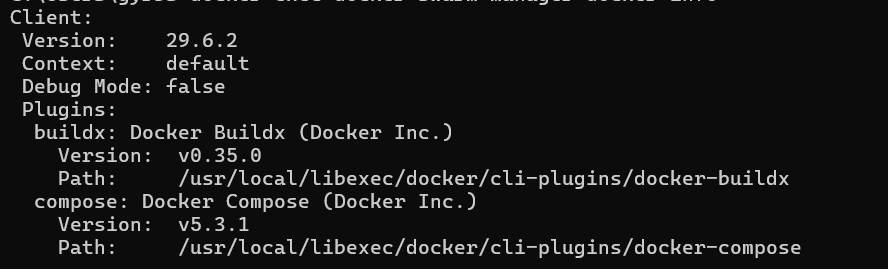
이후, manager docker에 들어가서 docker swarm init을 최초 실행한다.
docker exec -it docker-swarm-manager sh
docker swarm init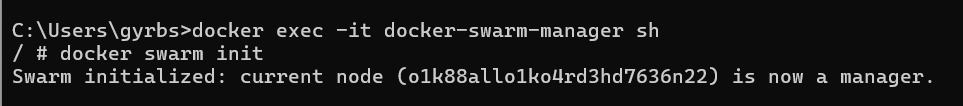
이에 따라 매니저 노드에 docker swarm이 실행되었음을 확인할 수 있으며, 참고로 이 docker swarm 실행 환경은 host 도커가 아닌 내부 dind 환경의 도커 엔진을 통해 실행된 환경이다.
docker swarm join --token SWMTKN-1-4blpvvhk0w2jppdo7r5pevfzl04p58rdh56noemr3d28hk0d79-9s3wwiiejxx6uhrltx7o9kd07 172.~~~~
그리고 다음의 CLI에서 토큰이 생성되었음을 확인할 수 있는데, 이 생성된 토큰을 worker 노드에게 제공하여 swarm 환경에 join하도록 구성한다.
docker exec -it docker-swarm-worker1 sh마찬가지로, 각 워커노드에 직접 접속하여 매니저 노드의 swarm 환경에 join하도록 한다.

워커 노드가 swarm에 join하였는지 확인하고,
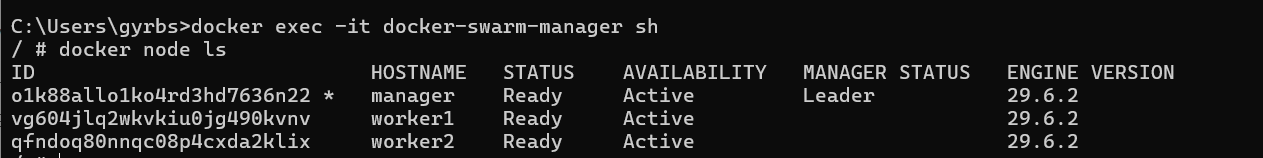
매니저 노드에서 docker node 목록이 잘 출력되는지, 관리가 되는지 확인한다.
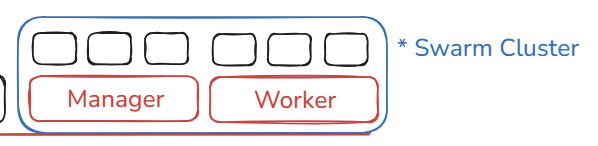
이를 통해, Manager 노드 산하 worker 노드가 swarm에 등록된 swarm cluster가 구성되었음을 확인할 수 있다.
6. Swarm Service
Service는 Swarm에 등록되어있는 노드들을 관리하고 목록을 확인하는 용도가 아닌, Swarm 클러스터 전체에서 각 노드들의 실행 상태를 정의하는 객체이다.
참고로 Docker Swarm은 각 노드들의 특정 상태를 정의한 각자의 객체로 구성되어있는데,
Swarm

├── Node
├── Service
├── Task
└── Network
Node(멀티 도커 엔진 목록), Service(Swarm 클러스터의 상태와 이에 대한 유지), Task(각 개별 컨테이너(엔진) 환경에 대한 상태와 유지), Network(각 멀티 엔진의 통신을 가능하게 하는 네트워크)로 이루어져 있으며, 다시 말하면 Docker Swarm으로 이루어진 클러스터 환경을 위 객체를 통해 상태 운영 및 유지를 할 수 있다는 의미이다.
이렇게 구성된 객체는 곧 사람이 각 컨테이너를 손수 운영할 필요 없이 하나의 객체를 통해 간편하게 확인하고 이에 대한 상태를 유지할 수 있다는 의미이기도 하다.
Service
(*Nodes = 3)

        │

 ┌──────┼─────────┐

 ▼      ▼         ▼

Task1  Task2   Task3

 │       │        │

 ▼       ▼        ▼

Container Container Container
더 이해하기 쉽게 말하면,
Swarm 클러스터에 구성된 별도의 이미지를
docker run ..
docker run ..
docker run ..
일일이 실행해주는 것이 아닌, Swarm의 원하는 상태를 기억하고 등록함으로써,
Swarm Service : Desired State

↓

node는 항상 3개 있어야 함
이에 대한 상태를 Manager 노드 측에 기억해두도록 하여, 번거로운 상태 유지 작업없이 그 "상태"를 기억하도록 하고 이를 "객체화"하여 원하는 Swarm의 상태를 유지하고 간편하게 실행할 수 있도록 도와주는 스위치같은 역할을 하는 것이다.
Docker Service : 현재 2개네?

↓

3개가 되어야 하는데?

↓

worker2에서 하나 더 실행
이러한 상태 및 원하는 형태를 객체화하고 기억하도록 하여, 단순 레지스트리의 개념이 아닌 간편한 상태 실행 및 유지를 가능하게 하는 것이 바로 Docker Swarm의 Service이다.
다시 들어가서, 현재 구성된 Swarm 노드 상태를 살펴보자.
현재 2개네?

↓

3개가 되어야 하는데?

↓

worker2에서 하나 더 실행
여기서, 각 노드안에 들어가 컨테이너 실행 상태를 확인해보면,
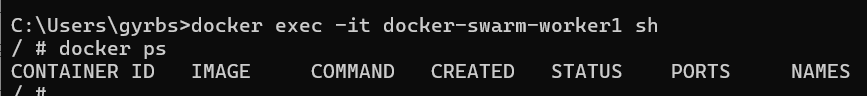
위와 같이 말 그대로 빈 껍데기(DinD), 도커 엔진만 실행하고 있음을 확인할 수 있다.
Service는 실행에 필요한 노드의 상태 뿐만 아니라, 내부의 세부 실행 내용까지 정의한다.
가령,
docker service create \
--name nginx \
--replicas 3 \
nginx
Service를 통해 정의한 각 멀티 컨테이너의 상태에 따라, DinD 내부에서 실행하는 task 내역까지 자동적으로 기억하고, 그대로 노드 실행 시 반영해줄 수 있는 것이다.
쉽게 말해, Service를 통해 정의한 "상태"에 따라 각 멀티 컨테이너의 실행 및 세부 실행 내역까지 정의해줄 수 있으며, 사람이 굳이 각 컨테이너 내부에서 nginx(위 정의에 따라)를 실행하지 않고도,
Worker1 / Worker2 / Manager

↓

docker run nginx
Manager가 알아서 각 노드들의 nginx 컨테이너를 실행하도록 유도하는 것이다. 물론, 상태 정의에 따라 Manager 자체적으로 nginx 컨테이너를 실행할 수 있기도 한다.
최종적인 실행 상태는,
Host Docker Engine
│
├── manager (DinD)
│      │
│      ├── Docker Engine
│      │
│      └── nginx Container
│
├── worker1 (DinD)
│      │
│      ├── Docker Engine
│      │
│      └── nginx Container
│
└── worker2 (DinD)
       │
       ├── Docker Engine
       │
       └── nginx Container
각 DinD(멀티 엔진)에서 nignx 컨테이너를 3개 실행한 상태가 된다. 참고로, Replica는 Node가 아닌 Node 내부에 실행하는 컨테이너, 즉 Task를 의미한다는 것을 잊지말자.
실제로 docker service를 적용해보자.
docker service create --name docker-service-nginx --replicas 3 nginx위와 같이 manager node에서 3개의 nginx 컨테이너 실행 상태를 기억하도록 service 객체를 생성하고, 각 노드 내부에 어떤 변화가 나타났는지 확인한다.
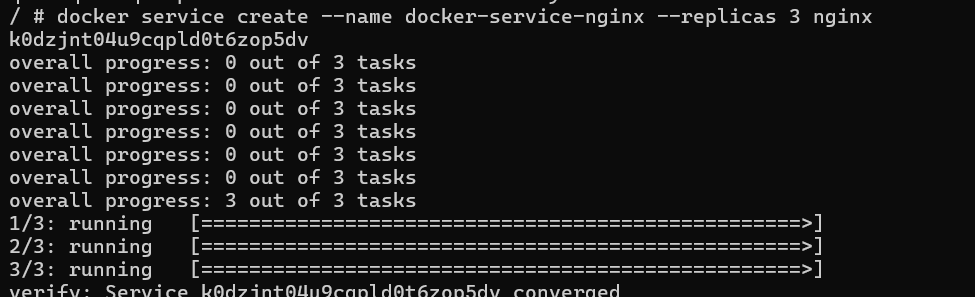
서비스 실행 완료 후, 위와 같이 각 노드의 run 내역을 정상적으로 확인한다.
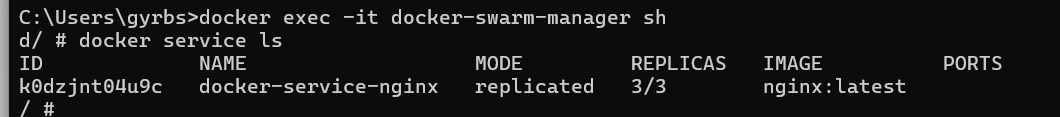
그 후, 매니저 노드 측에서 service 현황(Desired State)을 확인할 수 있고,

desired state에 대한 멀티 컨테이너의 세부 실행 현황까지 간편하게 확인할 수 있다(물론 이것도 매니저 노드에서 확인 가능, Host 엔진에서는 확인 불가).
이는 Docker Service를 시작했을때, Swarm 스케쥴러가 Manager Node를 통해 각 멀티 호스트의 Task 배치 및 컨테이너 실행까지 모두 완료하였음을 의미한다.

당연하게도 각 DinD(멀티 도커 엔진)에서 멀티 컨테이너가 자동으로, 간편하게 실행이 되었음을 확인할 수 있다.
물론 이러한 컨테이너 내역을 넘어,
docker service create \
  --name web \
  --replicas 3 \
  --publish 80:80 \
  --network frontend \
  --constraint node.role==worker \
  --limit-memory 512m \
  --reserve-memory 256m \
  --restart-condition any \
nginx:latest| 항목 | 의미 |
|---|---|
| 이름 | web |
| 이미지 | nginx:latest |
| Replica | 3개 유지 |
| 포트 | 80 공개 |
| 네트워크 | frontend |
| 배치 조건 | Worker 노드에만 배치 |
| 메모리 제한 | 최대 512MB |
| 메모리 예약 | 최소 256MB 확보 |
| 재시작 정책 | 종료되면 자동 재시작 |
이미지, task 내역, 포트, 네트워크, 배치하고자 하는 특정 노드, 메모리 제한 등 세부적인 실행 상태에 대해 정확하고 간편하게 정의(기억)해줄 수 있는 것이 특징이다. 이는 사실 단순한 특징을 넘어, 멀티 컨테이너 실행 환경의 관리를 편하게 해주는 강력한 도구이자 체계이다.
7. 노드의 자동 재시작(엔진 혹은 컨테이너 결함에 대한 자동 대응)
Docker Service를 실행하고 있는 상태에서 한 도커 엔진을 멈추었다고 가정하자.
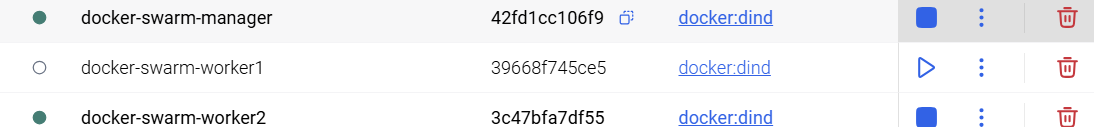
매니저 노드 측에 접속하여, docker service 현황을 살펴보면,
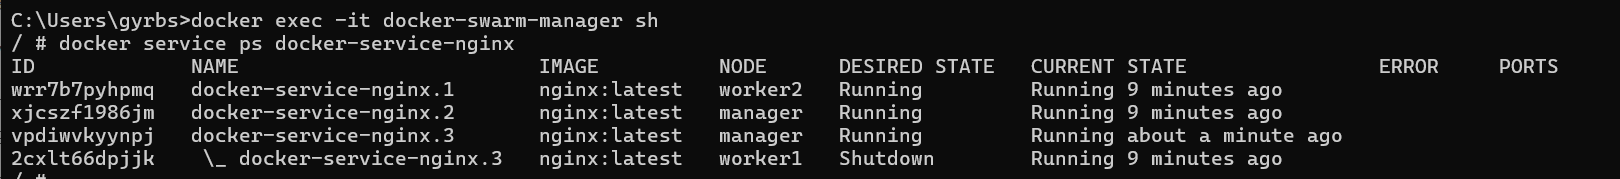
워커노드가 stop 하였지만, manager 노드 측에서 이에 대한 보완과정을 자동적으로 대응하여 nginx 3 task를 배치하였음을 확인할 수 있다. 게다가, 기존 shutdown된 노드와 새롭게 배치된 노드까지 관리하여 어느 노드에 문제가 생겼고, 이에 대한 대응 노드를 어떻게 마련했는지까지 명확하게 추적하고 확인할 수 있다.
참고로 Service를 삭제한다면, 그에 대한 "상태"까지 모두 삭제하여 각 멀티 도커 엔진에서의 컨테이너들을 모두 폭포수처럼 삭제하게된다.
docker service scale nginx-service=3service 객체에서 scale 명령을 통해 각 멀티 task의 상태를 조정할 수 있는데, 위와 같이 숫자를 조정하여 실행 상태를 늘리거나 줄일 수 있다.
참고로, 위 상태를 실행할 경우

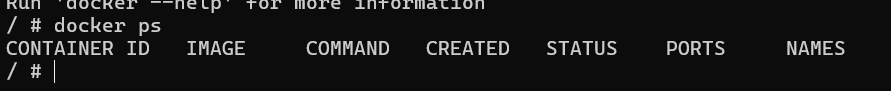
위와 같이 모든 멀티 컨테이너 실행을 한번의 cli를 통해 모두 잠시 멈춤(이미지 실행 멈춤)상태로 진입하였음을 확인할 수 있다.
8. Swarm Stack
Docker stack은 하나의 프로젝트, 서비스(다만 본 내용에서는 Docker Service와 구분하기 위해 프로젝트라는 단어를 사용)를 위해 여러 멀티 컨테이너 클러스터(Docker Service)를 논리적으로 묶어, 프로젝트 실행에 필요한 서비스들을 그룹화하는 것이다.
Docker Swarm Cluster
│
├── Stack (프로젝트 단위)
│     │
│     ├── Service (논리적 서비스)
│     │      │
│     │      ├── Task
│     │      │      │
│     │      │      └── Container
│     │      │
│     │      └── Task
│     │             │
│     │             └── Container
│     │
│     └── Service
│             │
│             └── Task
│                    │
│                    └── Container
│
└── Node
      ├── Manager
      └── Worker
Docker Stack 역시 Docker Swarm 체계에 기반한 논리적 객체이며, 애플리케이션 실행을 위해 필요한 논리적 단위이자 최상위 체계라 할 수 있겠다.
8-1. 데이터모델링의 관점 - Docker Stack은 논리적 단위이자 역할이다.
Service 단위는 하나의 Monolithic 프로젝트를 실행하는데 필요한 모든 컨테이너가 될 수 있고, 나아가 MSA를 구성하고 실행하는데 필요한 논리적 단위(컨테이너 집합)이 될 수 있을 것이다.
그리고, 이러한 MSA 단위로 분리된 Service를 묶는 단위가 Stack이 될 수 있고, 혹은 하나의 Monolithic 프로젝트를 실행하는데 필요한 Service 조각을 묶는 단위가 Stack이 될 수 있을 것이다.
하지만, Stack은 단순히 "묶는" 개념이 아니다.
Stack은 하나의 애플리케이션이며, Service는 그러한 애플리케이션을 구성하는 논리적인 단위이자 역할(Role)이다.
가령, 쇼핑몰 프로젝트를 아래와 같이 구성하였다고 가정하자.
React

↓

Spring Boot

↓

Redis

↓

MySQL
이것을 Docker Swarm을 적용하여 실행 단위를 구분한다고 하면, 아래와 같이 분리해볼 수 있을 것이다.
Shopping Mall(Stack)

├── frontend(Service)
├── backend(Service)
├── redis(Service)
└── mysql(Service)
여기서 Service란, 컨테이너를 묶는 단위가 아닌 특정 역할과 목적을 가지고 분리된 또 하나의 작은 체계이다. 물론, 그 체계가 모여 하나의 애플리케이션을 구성하게 된다.
backend를 위에서 적용한 docker service 객체 단위로 바라본다면,
backend(Service)

├── backend.1(Redis Container)
├── backend.2(MySQL Container)
└── backend.3(Kafka Container)
이와 같이, 백엔드 역할을 위해 모인 멀티 컨테이너, 작은 단위로 볼 수 있겠다.
단순히 멀티 컨테이너를 묶고 관리하는 단위로 이해한다면 어려운데, 위와 같이 애플리케이션이라는 하나의 체계를 구성하는 작은 단위, 특정 목적 및 역할을 수행하기 위해 필요한 요소라 보면 이해하기 용이할 것이다.
참고로, 이러한 구성은 모노 레포 혹은 멀티 레포와는 관련이 없다. 단순히 논리적 단위일 뿐이다.
이를 MSA 체계에서 바라보자.
Shopping Platform(Stack)

├── gateway(Service)
├── member-service(Service)
├── order-service(Service)
├── product-service(Service)
├── payment-service(Service)
├── notification-service(Service)
├── kafka(Service)
├── redis(Service)
├── member-db(Service)
├── order-db(Service)
└── product-db(Service)
쇼핑몰 Stack에 위와 같이 역할, 목적으로 세분화하여 각각을 논리적인 단위로 분리한다(Service).
각 Service 단위를 자세하게 분리해본다면,
Shopping Platform(Stack)

│

├── gateway(Service)
│      ├── gateway.1
│      └── gateway.2
│
├── member-service(Service)
│      ├── member.1
│      ├── member.2
│      └── member.3
│
├── order-service(Service)
│      ├── order.1
│      └── order.2
│
├── product-service(Service)
│      └── product.1
│
├── payment-service(Service)
│      └── payment.1
│
├── notification(Service)
│      └── notification.1
│
├── kafka(Service)
│      ├── kafka.1
│      ├── kafka.2
│      └── kafka.3
│
├── redis(Service)
│      └── redis.1
│
├── member-db(Service)
│      └── mysql.1
│
├── order-db(Service)
│      └── mysql.1
│
└── product-db(Service)
       └── mysql.1
위와 같이 하나의 큰 애플리케이션을 구성하는 객체로써, 각 객체의 역할과 목적을 구현하기 위한 작은 논리적 단위로 볼 수 있는 것이다.
물론, 운영적인 관점에서 Redis/MySQL의 물리적인 소유권은 분산 서비스가 모두 공유하되, 논리적인 소유권은 database(MySQL) 및 Schema(Oracle/PostgreSQL) 분리하는 형태로 관리할 수 있을 것이다.
다시 말해, 논리적인 체계를 분리하였다고 하여 데이터베이스까지 무작정 분리할 필요없다는 의미이다.
One Process per Container :
초기 MSA
──────────────────────────────

Shopping Stack

├── gateway(Service)
├── member-service(Service)
├── order-service(Service)
├── product-service(Service)
├── redis(Service)
└── mysql(Service)
      └── mysqld(Process)
            ├── member_db
            ├── order_db
            └── product_db
이러한 Monotlithic 구조에서, 대규모 데이터를 대응하기 위해 구조를 분산하였다면,
대규모 MSA
──────────────────────────────

Member Stack
├── member-service
└── member-db (MySQL Cluster)

Order Stack
├── order-service
└── order-db (MySQL Cluster)

Product Stack
├── product-service
└── product-db (MySQL Cluster)
위와 같이 전체 MSA 구조를 하나의 Stack으로 보는 것이 아니라, 각 MSA를 하나의 Stack으로 고려하고, 그에 맞게 물리적인/논리적인 DB Cluster를 구성하는 것이다.
Service per DB라는 것은 결국 체계를 어떻게 정의하고 구성하였는지, 그러한 체계에 따라 물리적, 논리적 단위를 어떻게 정의하고 구성할 것인지 유연하게 바라보아야 하는 문제라는 것이다.
Docker Stack은 결국 이러한 데이터 모델링, 서비스 구성 체계를 이해할 수 있는 중요한 개념으로 작용할 수 있음을 기억하도록 하자.
9. 도커 빌드를 통한 멀티 호스트 배포 환경에서의 Docker 3S 적용 방안
쇼핑몰 프로젝트를 역할에 맞게 영역을 분리하고, Redis 및 Kafka와 같은 분산 환경에서 사용하는 정합성 도구, 도메인이 물리적으로 공유하되 논리적 소유권을 분리한 MySQL을 구축한 상황을 가정해보자.
먼저, 도메인을 아래와 같이 분리하고 역할을 나눈다.
| 컴포넌트 | 역할 |
|---|---|
| Gateway | 모든 요청의 진입점 |
| Member | 회원 관리 |
| Order | 주문 처리 |
| Product | 상품 조회 |
| Redis | 로그인 세션, 캐시 |
| Kafka | 주문 이벤트 전달 |
| MySQL | 데이터 저장 |
이 역할을 처리할 API 서버를 구축한다고 가정하고, 서비스 흐름을 아래와 같이 정리해보자.
             Client
                │
                ▼
        Gateway(Spring Cloud Gateway)

                │
      ┌─────────┼─────────┐
      │         │         │
 Member      Order     Product
 Service     Service   Service

      │         │
      │         │
    Redis     Kafka
       \       /
        \     /
         MySQL
이러한 흐름에 기반하여, 3개의 노드(멀티 호스트 환경을 가정한)가 운용하는 Docker Service 및 Stack을 적용해보록 한다.
9-1. 인프라 선구축
단순하고 직관적으로, 프로젝트를 실행하기 전에 필요한 과정은 이를 뒤에서 받쳐주는 인프라(MySQL, Kafka, Redis)이다.
컴파일 과정에서도 이러한 인프라가 준비되지 않는다면 프로젝트는 실행되지 않는다.
따라서, 분산 환경을 받쳐주고 데이터의 상태를 저장하는 Redis/Kafka/MySQL를 먼저 올려보는 것으로 시작해본다.
docker exec -it docker-swarm-manager sh먼저, 매니저 노드에 들어간 후 브릿지 네트워크가 아닌 오버레이 네트워크를 구성해주어야 한다.
동일한 host 도커 엔진 위의 swarm 노드 간을 위한 호스트 데몬 상의 bridge 네트워크가 아닌, 서로 다른 도커 엔진에 구축되어있는 컨테이너 간의 통신을 위해 overlay 네트워크 구성이 반드시 필요하다.
docker network create --driver overlay docker-service-overlay참고로, overlay를 통해 컨테이너간 통신을 할 수 있는 논리적 연결이 구성된다면, host 도커 엔진 상의 브릿지 네트워크를 통해 물리적 연결이 이루어져 최종적으로 각 컨테이너간의 통신이 이루어진다.
bridge는 dind 노드들의 swarm을 위한 통신, overlay는 서로 다른 도커 엔진에서 동작하는 컨테이너들의 통신을 위한 연결 통로로 이해하면 되겠다.
오버레이 네트워크 구성 후, MySQL를 Docker Service로 구성한다.
docker service create --name docker-service-mysql --env MYSQL_ROOT_PASSWORD=1234 --network docker-service-overlay my
sql:8
이제 매니저는 worker 2개 중 적절한 곳에 mysql 컨테이너를 실행하게된다. 별도의 scaled-up option이 주어지지 않았기에 1개의 노드에 대해서만 컨테이너를 구축한다.
이는 사람이 굳이 특정 노드를 선택하고 내부에 들어가 컨테이너를 설치하지 않아도 된다. 매니저 노드가 간편하게 제어할 수 있는 부분으로, Swarm이 구축되어있기에 가능한 과정임을 숙지하도록 한다.


위와 같이 docker service가 정상적으로 동작하는지 확인하고, 마찬가지 방법으로 Redis를 docker service를 통해 구축한다.

매니저 노드에 위와 같이 Redis가 구축되어있는 것을 확인할 수 있다.
9-2. 서비스(Domain) 구축
이제 이러한 인프라 위에 도메인 영역(서비스)를 구축해보도록 한다.
docker service craete --name docker-service-gateway --publish 8080:8080 spring-cloud-gatewaydocker service create --name member --replicas 3 --env DB_HOST=mysql --env REDIS_HOST=redis shopping/member:1.0여기서 중요한 점은 도커 서비스 생성 시, 해당 서비스가 바라보는 것은 물리적인 DB의 주소 혹은 도커 서비스로 구성한 name(DNS)인 점이다.
이 역시도, Docker Swarm이 제공하는 서비스 디스커버리를 기반으로 상황에 따라 변경가능한 물리 IP 주소보다, 이에 매핑된 일관된 서비스명(DNS)을 통해 통신하여 안정적인 운영 및 연결이 가능하다는 것을 기억하자.
모든 컨테이너들은 각 인프라, 서비스들이 어느 엔진 혹은 노드에 배치가 되어있는지 모른다. 모든 것이 swarm에 의해 자동으로 관리, 운영될 수 있다.
서비스까지 구축한다면, service 실행 내역은 아래와 같다.
node1(manager)
===========================
gateway
member.1


node2(worker1)
===========================
mysql
member.2


node3(worker3)
===========================
redis
member.3
각 노드들은 네트워크를 적절히 경유하며 물리적 혹은 논리적 인프라 소유권을 가지며, 분산된 서비스를 운용하여 대용량 트래픽에 대비할 수 있는 환경을 기대할 수 있게된다.
그런데, 여기서 구축해야 하는 서비스가 수십개라면 어떻게 해야할까?
일일이 각 서비스마다 docker service ...를 수십번, 수백번 해야할까?
단순히 도커 서비스를 구성하는 번거로움의 관점이 아니라, 도커 네트워크 및 replica 개수 등을 일일이 정하고 입력해야 하는 관리 비용 관점에서의 비효율성이 생겨버린다.
10. Docker Stack을 통한 관리 간편성 및 효율성 제고
Docker stack은 Docker Swarm을 이용하되, Docker Service를 여러번 생성해야 하는 번거로움을 줄이기위해 Docker-compose.yml를 통해 필요한 서비스를 스크립트화(compose)하여 구성하는 것이다.
필요한 서비스가 있을때마다 직접 서비스를 만드는 것이 아닌, docker-compose.yml 파일을 통해 관리함으로써 사람 손으로 인한 여러가지 누락, 번거로움을 최소화하고 관리 효율성을 제고할 수 있게 된다.
구축 시 유의해야 하는 점은 위에서 거의 기술하였지만, 이 외 docker stack에서 중요한 점은 DinD 노드가 docker-compose를 읽을 수 있도록 로컬 파일을 마운트한다는 정도이다.
docker stack을 실행하는 매니저 노드는 호스트 도커 데몬의 로컬 파일을 raw하게 읽을 수 없다.
이를 위해, 해당 매니저 노드안에서 compose 파일을 직접 생성 및 복사하거나, DinD 생성 시 볼륨 마운트 경로를 지정하여 호스트 데몬의 로컬 파일 경로에 위치하거나 하여 stack 스크립트를 구성해줄 수 있다.
node1 (Manager)

kafka.1
member.1

--------------------

node2

mysql
kafka.2
member.2

--------------------

node3

redis
kafka.3
member.3
만약 위와 같이 kafka replica 3개를 추가해야 한다면, 기존의 docker service 생성을 하지 않고 docker-compose 구성 및 이를 실행하여 상대적으로 간편하게 프로젝트를 구성하고 이에 대한 컨테이너들을 편하게 관리할 수 있다는 장점이 생긴다.
이것이 바로 Docker Stack의 힘이다.
11. 결론
Docker를 단순히 리눅스의 namespace 분리를 사용하는 기술적 영역이 아닌, 프로젝트 운영의 편리함을 제고하기 위한 시스템 모델링의 관점에서 볼 수 있었던 매우 흥미로운 과정이었던것 같다.
이러한 이해없이, 무작정 현대 Devops에서 필수적으로 사용하는 쿠버네티스를 무작정 부딪힌다면 왜 이것이 필요한지, 이것이 어떤 계기로 널리 알려지고 활용이 되게 되었는지라는 의문없이 파도에 휩쓸려 사용하는 모순적인 상황이 발생하였을 것이다.
더불어 쿠버네티스가 없다면 Docker Swarm, Stack을 사용하면 될 것이다. 그만큼 시스템 배포의 선택폭이 넓혀졌다는 것을 의미하기도 한다.
지금의 과정, 이해를 바탕으로 시스템을 좀 더 본질적으로 바라보고, 더 넓은 선택의 폭으로 실무에서 적절하게 배포 환경을 구축할 수 있도록 해보자.
12. 참고자료
Docker Swarm - https://velog.io/@1996yyk/Docker-Swarm-%EC%97%90-%EB%8C%80%ED%95%B4%EC%84%9C