
어느덧 입사한 지 어느덧 4년이 지났다. 그동안 대한항공 프로젝트를 3개 정도 진행하면서 많은 것을 배웠는데, 그중에서도 지금까지 가장 기억에 남는 경험은 현재 진행 중인 프로젝트를 안정화시키면서 여러 장애를 직접 추적하고 해결했던 과정이다.
DB Connection 설정
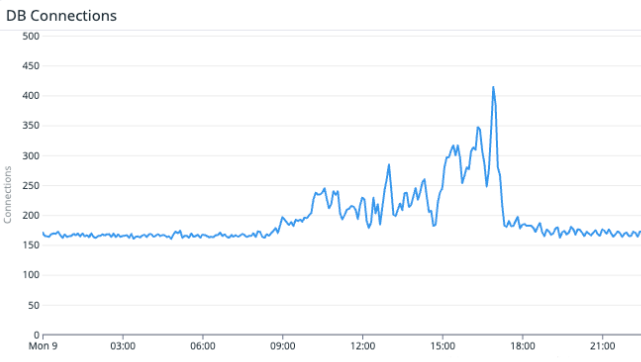
SM을 진행하면서 분기마다 대규모 이벤트가 있었고, 이벤트가 시작될 때마다 서비스가 불안정해졌다. 일부 요청은 재처리가 필요했고, 장애 로그와 에러 알림도 반복적으로 쌓였다. 특히 모니터링을 하던 중 DB Connection 수가 비정상적으로 증가하는 현상을 발견했다.
기본적으로 애플리케이션 파드가 2개일 때 약 150개의 Connection을 사용하고 있었는데, 이벤트 시점에 오토스케일링으로 파드가 4개까지 늘어나면 단순 계산으로는 약 300개 수준이 되는 것이 자연스럽다. 그런데 실제 운영 DB에서는 400개에 가까운 Connection이 잡히고 있었다. 남은 100개의 Connection이 어디서 발생하는지부터 확인해야 했다.
찾았다 범인?
처음에는 애플리케이션 파드 외부에서 생성되는 Connection이라고 판단했다. DB Connection을 추가로 맺을 수 있는 컴포넌트를 추적하던 중, 배치 프로젝트에서 사용하지 않는 커넥션 풀이 그대로 남아있는 것을 발견했다. 과거 샘플 코드가 그대로 포함되어 있었고, 실제로 사용하지 않는 DataSource가 약 30개의 Connection을 점유하고 있었다.
사용하지 않는 커넥션 풀을 제거하면 바로 효과가 있을 것이라고 생각했지만, 운영 환경에서는 기대했던 만큼 Connection 수가 줄지 않았다. 원인을 다시 살펴보던 중, 배치 프로젝트의 구조 자체에 문제가 있다는 것을 알게 되었다.
진짜로 찾은 범인
해당 배치 프로젝트는 상시 실행되는 서비스가 아니라 Fargate on EKS 기반으로 동작하고 있었다. 즉, 배치가 실행될 때만 파드가 생성되고 작업이 끝나면 파드가 종료되는 구조였다. 그런데도 기본 설정으로 HikariCP의 커넥션 풀이 아래와 같이 잡혀 있었다.
-- AI 샘플 코드 입니다.
spring:
  datasource:
    url: jdbc:mysql://localhost:3306/mydb
    username: user
    password: password
    driver-class-name: com.mysql.cj.jdbc.Driver
    hikari:
      pool-name: MyHikariPool
      # 최대 커넥션 수
      maximum-pool-size: 15
      # 최소 유지 커넥션 수
      minimum-idle: 15
minimum-idle 이 15로 설정되어 있었기 때문에, 배치 파드가 생성되는 순간 실제로 DB를 사용하지 않더라도 최소 15개의 Connection을 미리 확보하고 있었다. 이벤트 시점에는 여러 개의 배치 파드가 동시에 생성되었고, 결국 사용하지도 않는 Connection이 대량으로 DB에 쌓이고 있었다.
배치 작업의 특성을 생각해보면, 한 번 실행될 때 병렬로 많은 쿼리를 수행하는 구조가 아니었다. 대부분 순차적으로 데이터를 조회하고 처리하는 작업이었기 때문에, 항상 15개의 Connection을 유지할 필요가 없었다. 따라서 운영 리스크를 최소화하기 위해 maximum-pool-size 는 유지하되, minimum-idle 설정만 제거하도록 변경했다.
필자 생각으로는 미니멈 숫자와 맥시멈 숫자를 동일하게 작성하여 첫 요청 지연을 감소시키고 Connection 생성 비용을 제거하려고 하지 않았을까 싶다.
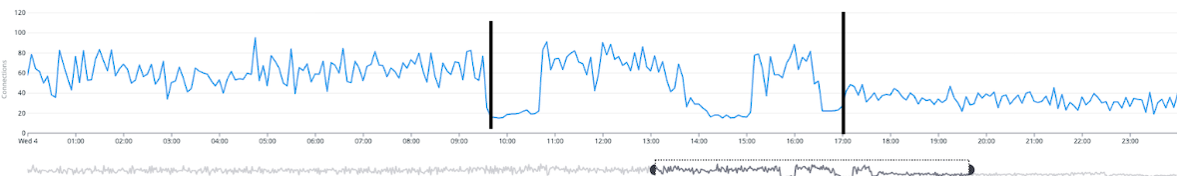
변경 후 DEV 환경에서 테스트를 진행한 결과, 사용하지 않는 커넥션 풀을 제거했을 때보다 훨씬 큰 효과가 나타났다. 기존에는 배치 파드가 생성되는 순간 곧바로 15개의 Connection을 점유했지만, 변경 이후에는 실제 쿼리가 수행되는 시점에만 필요한 만큼 Connection이 생성되었다.
그 결과 전체 Connection 수가 눈에 띄게 감소했다.
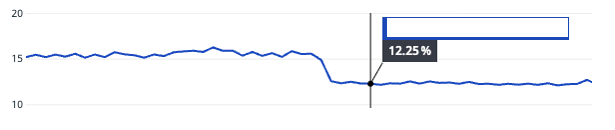
운영 반영 이후에는 효과가 더 명확하게 드러났다. 이벤트 시점에도 DB Connection 수가 이전보다 훨씬 안정적으로 유지되었고, 운영 DB의 CPU 사용량 역시 약 20% 정도 감소했다.
또한 각 배치 작업에 Connection 관련 모니터링 로그를 추가하여 혹시라도 Connection 부족으로 인해 처리 속도가 느려지거나 실패하는 경우가 없는지 지속적으로 확인했다.
다행히 현재까지 별다른 문제 없이 안정적으로 운영되고 있다.
공통코드 캐시 적용
두번째로는 자주사용하는 공통 코드에 대해서 캐시를 적용하는 부분이다.
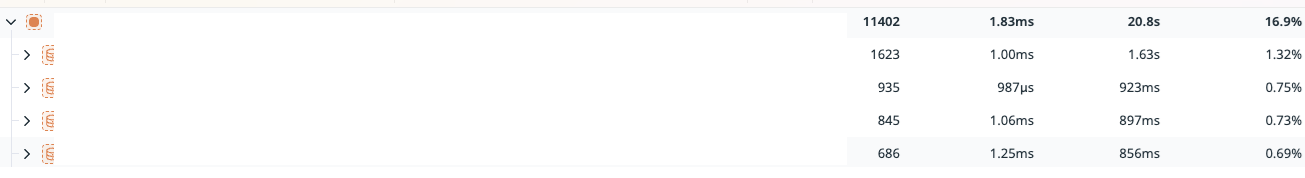
사진에서 보이는 것과 같이 배치 로그를 분석해보니, 실제로 처리하는 데이터는 약 600건 정도였지만 공통 코드 조회 쿼리는 그보다 훨씬 많이 수행되고 있었다. 공통 코드 조회 로직이 여러 서비스와 반복문 안에서 공통적으로 호출되다 보니, 동일한 값을 계속해서 DB에서 다시 읽어오고 있었던 것이다.
처음에는 공통 코드를 어디에 캐싱할지 고민했다. 선택지는 크게 두 가지였다.
- 로컬 캐시
- Redis 기반 분산 캐시
처음에는 Redis를 사용하는 것도 고려했다. 여러 파드가 동일한 캐시를 공유할 수 있고, 추후 다른 서비스에서도 재사용할 수 있기 때문이다. 하지만 현재 공통 코드 데이터는 자주 변경되지 않고, 데이터 양도 크지 않았으며, 배치 파드 내부에서만 사용되는 값이었다. 이런 상황에서 Redis를 도입하면 다음과 같은 추가 비용이 발생한다.
- Redis 인프라 운영 및 모니터링 필요
- 장애 발생 시 Redis까지 함께 확인해야 하는 운영 복잡도 증가
- 네트워크 호출이 추가되어 오히려 단순 조회보다 느려질 가능성
- 캐시 만료 정책, 동기화, 장애 복구 전략까지 별도로 관리 필요
반면 로컬 캐시는 애플리케이션 내부 메모리를 사용하기 때문에 별도의 인프라가 필요하지 않다. 단순히 Caffeine 과 같은 라이브러리만 적용하면 바로 사용할 수 있었고, 현재 구조에서는 오히려 더 적합했다.
특히 로컬 캐시를 선택하면서 다음과 같은 장점을 얻을 수 있었다.
- 네트워크 호출 없이 메모리에서 바로 조회하므로 응답 속도가 가장 빠름
- Redis 장애와 무관하게 애플리케이션 단독으로 동작 가능
- 배치 파드가 생성될 때 필요한 공통 코드만 캐싱하고 종료되므로 메모리 누수 위험이 적음
- 배치 특성상 파드가 짧게 살아 있기 때문에 캐시 정합성 문제를 크게 고려하지 않아도 됨
- 운영 포인트가 줄어들어 장애 원인 분석이 단순해짐
- 공통 코드 조회 쿼리가 크게 줄어들면서 DB 부하와 Connection 사용량도 추가로 감소
결국 현재 프로젝트에서는 Redis보다 로컬 캐시가 더 단순하고 효율적인 선택이었다. 실제 적용 이후에는 동일한 공통 코드 조회가 반복되지 않게 되었고,
DB 쿼리 수와 처리 시간 모두 눈에 띄게 줄어드는 효과를 확인할 수 있었다.
s3 병렬 업로드
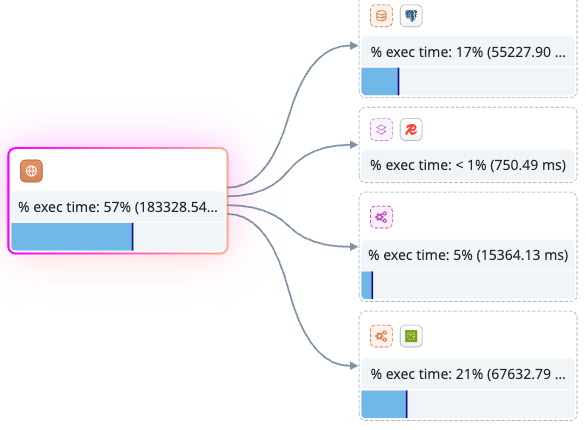
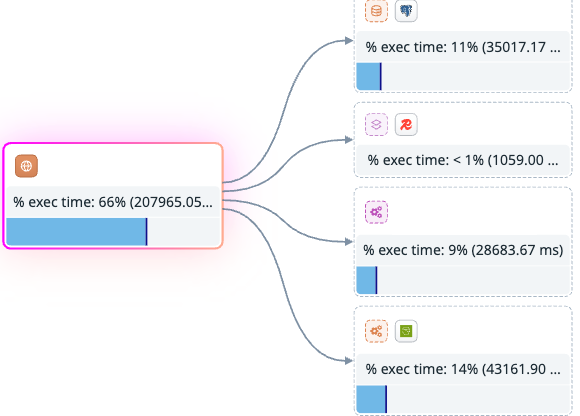
600개의 데이터를 처리한다고 했을 떄 현재 sm 진행하고 있는 프로젝트에서는 한영중일 4개의 언어를 제공하기 때문에 각 언어별 S3 를 저장한다고 봤을때 총 2400개의 파일을 업로드하게 된다.
한번 업로드할 때 마다 10~30MS 라서 신경을 안쓰고 있다가 모니터링 진행하면서 너무 많은 시간을 잡아먹는다는 것을 확인했다.
따라서 4개의 언어로 정해져 있기 때문에 병렬로 진행해도 cpu 부하가 일반적으로 적으며 AWS 에서 제공하는 병렬 업로드를 사용하기에는 버전 업을 진행해야 하기 때문에 부담스러운 와중에 간단히 JAVA 소스코드 상에서 pararellelStream 을 사용하여 병렬 작업을 진행하였다.
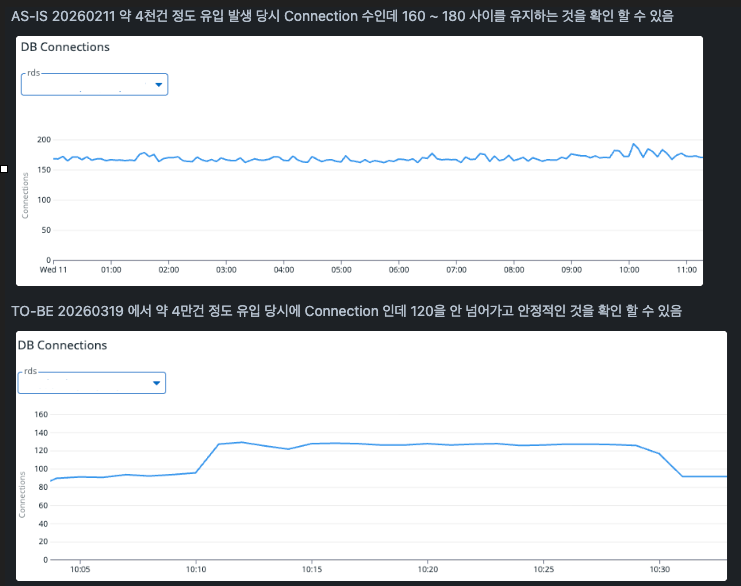
아래의 사진은 AS-IS , TO-BE 인데 DB 사용량 시간과 s3 업로드 시간이 줄어든 것을 확인할 수 있다.
간헐적 502, 504 에러
또 다른 문제는 운영 환경에서 간헐적으로 발생하던 502 Bad Gateway, 504 Gateway Timeout 오류였다.
특히 이벤트 시점이나 배포 직후에만 간헐적으로 발생했기 때문에 처음에는 단순한 순간 부하 문제라고 생각했다. 하지만 장애가 반복되면서 정확한 원인을 추적하기 위해 ALB 로그부터 확인했다.
AWS Application Load Balancer 로그를 분석해보니, 장애가 발생한 요청의 주요 값이 아래와 같이 기록되어 있었다.
request_processing_time = 0
target_processing_time = 0
response_processing_time = -1
이 값의 의미는 다음과 같다.
request_processing_time = 0
ALB가 요청을 받는 데는 문제가 없었다.
target_processing_time = 0
요청이 실제 Pod까지 전달되지 못했다.
response_processing_time = -1
대상 서버로부터 응답 자체를 받지 못했다.
즉, 502 오류는 애플리케이션 내부에서 발생한 것이 아니라, ALB가 Pod와 연결을 맺는 과정에서 이미 실패하고 있다는 뜻이었다. 다시 말해 요청이 애플리케이션까지 도달하기 전에 끊기고 있었다.
원인을 계속 추적하던 중, ALB의 Idle Timeout과 Pod 내부 Keep-Alive Timeout 값이 맞지 않는다는 점을 발견했다.
당시에는 Pod의 Keep-Alive 시간이 ALB Idle Timeout보다 더 길게 설정되어 있었다. 이 경우 Pod는 아직 연결이 살아 있다고 생각하지만, ALB는 이미 해당 연결을 종료한 상태가 된다. 이후 ALB가 이미 종료된 연결을 재사용하려고 하면 간헐적으로 502가 발생할 수 있다.
따라서 먼저 ALB Idle Timeout을 Pod의 Keep-Alive Timeout보다 조금 더 짧게 조정했다. 즉, ALB가 먼저 연결을 정리하도록 변경하여, 이미 끊어진 Connection을 재사용하지 않도록 만든 것이다.
예를 들어 다음과 같은 구조로 맞췄다.
ALB Idle Timeout      : 55s
Tomcat Keep-Alive     : 60s
이렇게 하면 ALB가 먼저 Connection을 종료하고, Pod는 이미 종료된 Connection을 다시 사용하려고 하지 않게 된다. 실제로 설정 이후 일부 502 오류는 감소했지만, 장애가 완전히 사라지지는 않았다.
추가로 애플리케이션 서버 설정을 점검하던 중, 백엔드 서버의 Apache Tomcat 설정이 지나치게 보수적으로 잡혀 있다는 점을 발견했다.
server:
  tomcat:
    connection-timeout: 2s
    max-connections: 100
문제는 두 가지였다.
connection-timeout: 2s
ALB와 Pod가 연결을 맺는 과정에서 네트워크 지연이나 순간적인 부하가 발생하면, 2초 안에 연결이 완료되지 못하고 바로 타임아웃이 발생했다.
max-connections: 100
기본값인 100은 평상시에는 문제가 없었지만, 이벤트 시점처럼 순간적으로 요청이 몰릴 경우 너무 작은 값이었다. 100개의 Connection이 모두 사용되면 이후 요청은 연결조차 맺지 못하고 ALB에서 502 또는 504로 처리될 수 있었다.
따라서 아래와 같이 설정을 변경했다.
server:
  tomcat:
    connection-timeout: 10s
    max-connections: 1000
connection-timeout을 늘려 순간적인 지연에도 충분히 연결을 맺을 수 있도록 했고, max-connections 역시 실제 트래픽 규모에 맞게 확대했다.
변경 후에는 이벤트 시점에 발생하던 간헐적인 502, 504 오류가 대부분 사라졌고, 특히 ALB 로그에서도 더 이상 target_processing_time = 0 형태의 요청이 거의 발생하지 않게 되었다.
끝날 때 까지 끝나지 않았다.
하지만 모든 장애가 해결된 것은 아니었다. 배포 직후에는 여전히 짧은 시간 동안 502 오류가 간헐적으로 발생했다.
이 문제는 트래픽이 아직 준비되지 않은 Pod로 전달되면서 발생하고 있었다. 기존에는 단순 Rolling Update 전략을 사용하고 있었는데, 새 Pod가 생성되자마자 아직 애플리케이션 초기화가 끝나지 않았음에도 ALB가 곧바로 트래픽을 보내고 있었다.
이 시점에 요청이 들어오면 Pod는 아직 응답할 준비가 되지 않았기 때문에 502가 발생했다.
이를 해결하기 위해 먼저 쿠버네티스의 Readiness Probe와 Readiness Gate를 적용했다. Pod가 완전히 준비되기 전까지는 ALB Target Group에 Healthy 상태로 등록되지 않도록 만든 것이다.
Kubernetes 의 Readiness Gate를 적용한 이후에는 다음 조건이 모두 만족되어야만 트래픽이 전달되도록 변경했다.
즉, 새 버전 Pod를 먼저 충분히 기동하고, Readiness 상태와 실제 트래픽 테스트까지 완료한 뒤에만 사용자 요청을 넘기도록 변경했다. 그 결과 배포 직후에만 발생하던 간헐적인 502 오류까지 제거할 수 있었고, 현재는 이벤트 시점과 배포 시점 모두에서 안정적으로 운영되고 있다.
POSTGRESQL 최적화 진행하기
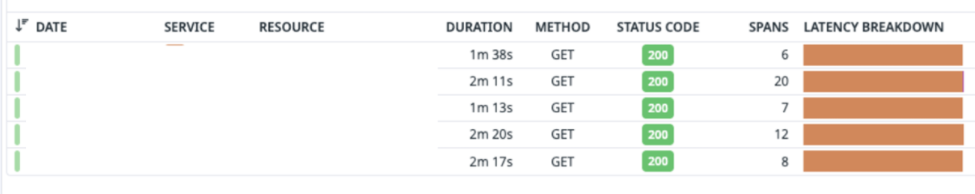
추가로 장애를 추적하던 과정에서, 특정 시점부터 메인 조회 API의 응답 시간이 점점 느려지고 있다는 것도 발견했다. 애플리케이션 로그만으로는 원인을 찾기 어려웠기 때문에 Datadog 의 APM Trace를 확인했다.
Trace를 분석해보니 특정 API 하나에서 대부분의 응답 시간이 소비되고 있었고, 그 안에서도 메인 조회 쿼리가 비정상적으로 오래 걸리고 있었다. 동일한 API인데도 어떤 요청은 수백 ms 안에 끝나고, 어떤 요청은 수 초 이상 걸리는 현상이 반복되고 있었다.
원인을 찾기 위해 Trace에 남아있는 URL과 파라미터를 기반으로 실제 Slow Query가 어떤 조건으로 호출되는지 확인했다.
처음에는 기존에 생성되어 있던 인덱스를 타고 있을 것이라고 생각했다. 하지만 실제로는 인덱스를 전혀 사용하지 못하고 있었고, 결국 파티션 전체를 순차적으로 읽는 방식으로 실행되고 있었다.
먼저 실제 인덱스 사용량과 Scan 비율을 확인하기 위해 아래 쿼리를 사용했다.
SELECT
    schemaname,
    relname AS table_name,
    indexrelname AS index_name,
    idx_scan,
    idx_tup_read,
    idx_tup_fetch,
    CASE
        WHEN idx_scan = 0 THEN 'NOT USED'
        WHEN idx_tup_read > idx_tup_fetch * 5 THEN 'INEFFICIENT'
        ELSE 'USED'
    END AS status
FROM pg_stat_user_indexes
WHERE relname = 'sample_table'
ORDER BY idx_scan DESC;
각 컬럼의 의미는 다음과 같다.
idx_scan : 해당 인덱스를 사용한 횟수
idx_tup_read : 인덱스를 통해 읽은 row 수
idx_tup_fetch : 실제 테이블까지 접근해서 가져온 row 수
예를 들어 아래와 같은 결과가 나왔다면:
index_name                  idx_scan    idx_tup_read    idx_tup_fetch
idx_old_search                  0              0                0
idx_created_at_status        15000       24000000         20000000
idx_old_search 는 한 번도 사용되지 않았고, 반대로 기존에 사용할 것이라고 예상했던 컬럼 조합도 실제로는 원하는 방식으로 사용되지 않고 있다는 뜻이었다.
처음에는 기존 인덱스를 그대로 활용할 수 있을 것이라고 생각했지만, 실제 조건 순서와 정렬 조건을 고려했을 때 현재 쿼리에 맞는 인덱스를 새로 만들어야 했다. 우선 SO님과 함께 현재 사용되지 않는 인덱스들을 검토했고, 실제로 한 번도 사용되지 않는 인덱스는 제거하기로 했다.
대상 테이블은 월별 파티션 테이블이었고, 파티션 테이블에서는 일반 테이블처럼 한 번에 CREATE INDEX CONCURRENTLY 를 사용할 수 없었다. 부모 파티션에 바로 Concurrently 인덱스를 생성할 수 없기 때문에, 먼저 부모 테이블에 메타데이터 역할만 하는 "깡통 인덱스"를 만든 뒤, 각 파티션에 실제 인덱스를 생성해서 연결해야 했다.
우선 부모 테이블에 아래와 같이 인덱스를 생성한다.
ON ONLY 를 사용하면 부모 테이블에만 인덱스 메타데이터가 생성되고, 실제 각 파티션에는 아직 인덱스가 생성되지 않는다.
그 다음 각 월별 파티션에 실제 인덱스를 생성한다.
CREATE INDEX idx_sample_search
ON ONLY sample_table (
    company_id,
    status,
    created_at DESC
);
ALTER INDEX idx_sample_search
ATTACH PARTITION idx_sample_search_202601;

ALTER INDEX idx_sample_search
ATTACH PARTITION idx_sample_search_202602;

ALTER INDEX idx_sample_search
ATTACH PARTITION idx_sample_search_202603;

ALTER INDEX idx_sample_search
ATTACH PARTITION idx_sample_search_default;
당시 생성해야 하는 인덱스가 3개였고, 월별 파티션 기준으로 1년이면 총 36개의 인덱스를 생성해야 했다. 만약 모두 순차적으로 작업했다면 상당한 시간이 필요했기 때문에, 조회가 거의 발생하지 않는 이전 월 파티션은 동시에 병렬로 생성했다.
반면 현재 월 파티션은 실제 서비스 요청이 계속 들어오고 있었기 때문에, 해당 월 파티션만 별도로 조심해서 작업했다. 파티션 테이블은 특정 월을 조회하면 해당 월 파티션에만 Lock이 걸리므로, 운영 영향도를 최소화하기 위해 현재 월 파티션만 단독으로 생성하고 나머지는 병렬 처리했다.
또한 Default 파티션이 존재한다면, 마지막으로 Default 파티션에도 동일한 인덱스를 생성해야 한다.
CREATE INDEX CONCURRENTLY idx_sample_search_default
ON sample_table_default (
    company_id,
    status,
    created_at DESC
);
모든 파티션 인덱스 생성이 끝났다면 마지막으로 부모 인덱스에 연결한다.
연결이 끝나면 PostgreSQL 은 부모 인덱스를 기준으로 각 파티션 인덱스를 자동으로 인식하게 된다.
이후 다시 실행 계획을 확인해보니, 기존의 Seq Scan 이 사라지고 기본 1~2분 걸리던 api 가 20초 이내로 실행되는 것을 확인하였다.
추가적으로 dbeaver에서 작업을 진행하게 되면 select 락 및 테이블을 클릭하여 테이블 구조를 보는 행위를 하면 락을 잡아 인덱스 생성에 애를 먹었던 기억이 있다. 만일 concurrently 로 인덱스 생성시에 과도하게 시간이 오래 걸린다고 하면 활성 process 를 확인하고 dbeaver가 lock 을 점유하고 있는지 확인해보자
고수;