Golden은 “무엇을 시험할지”, LLMTestCase는 “실제로 실행된 한 건”, EvaluationDataset은 “이 평가 항목들을 관리하는 묶음” 이다.
Golden(평가 설계)
    ↓ LLM/RAG/Agent 실행
LLMTestCase(실행 결과가 포함된 평가 단위)
    ↓ 여러 건을 저장·반복 실행
EvaluationDataset(평가 데이터 모음)
1. Golden
아직 실행되지 않은 테스트케이스의 템플릿. pending test case
from deepeval.dataset import Golden

golden = Golden(
    input="환불은 며칠 안에 신청해야 하나요?",
    expected_output="구매 후 30일 이내에 환불을 신청할 수 있습니다.",
    context=["환불은 구매일로부터 30일 이내에 신청할 수 있습니다."],
)
주요 파라미터는 아래와 같다.
- input: 사용자 입력. 필수
- expected_output: 기대하는 모범 응답. 선택
- context: 사람이 검토한 정답 근거. 선택
- expected_tools: Agent가 호출해야 할 도구. 선택
그 밖에 메타데이터, 코멘트 등을 저장할 수 있음
언제 사용하는가?
같은 평가 입력을 여러 버전에 반복 적용할 때 사용한다.
- 모델 A와 모델 B 비교
- 프롬프트 v1과 v2 비교
- RAG retriever 변경 전후 비교
- 배포 전 회귀 테스트
- 아직 LLM이 처리하지 않은 평가 질문 준비
- 문서에서 합성 평가 데이터 생성
⠀실행할 때마다 새로운 actual_output 이 만들어지는데 이것과 비교한다. 따라서 Golden 은 특정 모델 실행 결과와 분리된 재사용 가능한 평가 명세다.
왜 여러 Golden 이 필요한가?
테스트 데이터용도로 여러가지 Golden 데이터를 준비해야한다. 하나의 사례만 통과하면 그 문장 하나에만 잘 맞는 앱이나 rubric을 만들 수 있다. 여러 golden은 표현차이, 정책의 경계, 결함, 고위험 행동을 서로 다른 사례로 보호하기 위해 필요하다.
metadata
golden에는 테스트데이터 들에 대한 metadata를 dictionary의 형태로도 지정할 수 있다.
여기에는 테스트케이스 id를 포함하여 여러가지 정보들을 넣을 수 있다.
나는 아래와 같이 했는데 정답은 없다.
{
  "case_id": "{테스트케이스의 아이디}",
  "category": "{테스트케이스의 카테고리, 대/중/소 분류로 더 나눌 수도 있다.}",
  "protected_risk": "{이 케이스의 목적 / 확인하고자 하는 리스크}",
  "suspected_component": "{이 케이스가 실패했을 때 의심해야할 컴포넌트}",
  "suite": "{테스트케이스 suite의 종류}",
  "review_status": "{이 테스트가 이해관계자들에 의해 리뷰완료되었는지}",
}
특히, id 값은 꼭 넣어주는게 좋은데, Golden 자체에는 id값이 따로 없기 때문에 추적하기 위해서는 넣어주는 것이 좋다. id 에 대해서는 아래 다른 섹션에서 좀 더 기재해본다.
2. LLMTestCase
LLM 애플리케이션에서 발생한 한 번의 실제 상호작용을 평가 가능한 형태로 표현한 객체다.
from deepeval.test_case import LLMTestCase

test_case = LLMTestCase(
    input="환불은 며칠 안에 신청해야 하나요?",
    actual_output="구매 후 14일 이내에 신청해야 합니다.",
    expected_output="구매 후 30일 이내에 신청할 수 있습니다.",
    context=["환불은 구매일로부터 30일 이내에 신청할 수 있습니다."],
    retrieval_context=[
        "일반 상품은 구매 후 30일 이내에 환불할 수 있습니다."
    ],
)- input: 애플리케이션에 들어간 사용자 입력
- actual_output: 현재 애플리케이션이 실제로 생성한 응답
- expected_output: 기대 응답
- context: 정답으로 간주하는 기준 근거
- retrieval_context: RAG retriever가 실제로 검색한 문서
- tools_called: Agent가 실제로 호출한 도구
- expected_tools: 호출하기를 기대한 도구
- token_cost: 토큰 비용
- completion_time: 응답 시간
보통은 input과 actual_output을 기본으로 사용하되, 평가가 필요한 메트릭이 요구하는 필드가 반드시 있어야한다.
예를 들면 아래와 같다.
| 평가 목적 | 일반적으로 필요한 필드 |
|---|---|
| 답변 관련성 | input, actual_output |
| 기대 답변과 정확성 비교 | actual_output, expected_output |
| RAG 생성 답변의 충실성 | actual_output, retrieval_context |
| Retriever 재현율 | input, expected_output, retrieval_context |
| Agent 도구 선택 정확성 | tools_called, expected_tools |
| 독성 검사 | actual_output |
언제 사용하는가?
- 응답 하나를 즉석에서 평가할 때
- pytest 테스트 한 건을 작성할 때
- 특정 실패 사례를 디버깅할 때
- RAG의 한 번의 실행결과를 평가할 때
- Agent가 실제로 호출한 도구를 검사할 때
- 이미
actual_output이 포함된 운영 데이터를 평가할 때 - end-to-end 또는 특정 컴포넌트 상호작용을 평가할 때
from deepeval import evaluate
from deepeval.metrics import AnswerRelevancyMetric
from deepeval.test_case import LLMTestCase

test_case = LLMTestCase(
    input="환불 기간은?",
    actual_output="구매 후 30일 이내입니다.",
)

evaluate(
    test_cases=[test_case],
    metrics=[AnswerRelevancyMetric()],
)
-> 실제 결과가 포함되어있는 특정한 테스트케이스에 대해 특정 지표를 평가한다.
3. EvaluationDataset
Golden과 실행된 test case를 일관되게 보관·로드·순회하는 컨테이너다. goldens의 collection. 일반적인 사용은 golden을 넣지만, test_case를 넣는 경우도 있다.
from deepeval.dataset import EvaluationDataset, Golden

dataset = EvaluationDataset(
    goldens=[
        Golden(
            input="환불 기간은?",
            expected_output="구매 후 30일 이내입니다.",
        ),
        Golden(
            input="배송비도 환불되나요?",
            expected_output="상품과 환불 사유에 따라 달라집니다.",
        ),
    ]
)
언제 사용하는가?
- 평가 케이스가 여러 개 일 때
- 동일한 평가 세트를 반복 실행할 때
- pytest parameterization에 연결할 때
- JSON, JSONL, CSV 등으로 저장하거나 불러올 때
- 합성된
Golden을 모아 관리할 때 - CI에서 회귀 평가를 수행할 때
- 모델이나 프롬프트 버전별 결과를 비교할 때
하나의 EvaluationDataset 은 다음 중 하나로만 구성된다.
- Single-turn : Golden / LLMTestCase
- Multi-turn : ConversationalGolden / ConversationalTestCase
두 종류를 하나의 데이터셋에 넣을 수는 없다.
데이터 로드
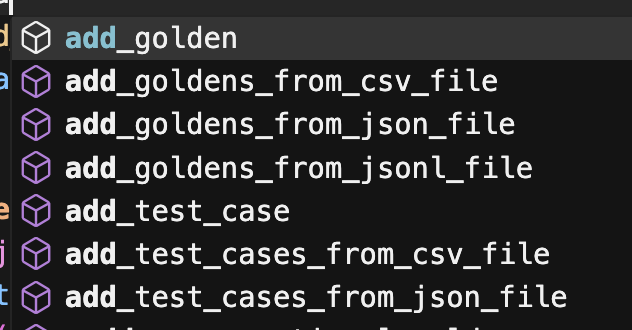
EvaluationDataset 은 한 번에 대량의 데이터를 로드할 수 있는 메소드를 기본으로 제공한다.
세 개념이 한 번에 사용되는 과정
from deepeval.dataset import EvaluationDataset, Golden
from deepeval.test_case import LLMTestCase
from deepeval import evaluate
from deepeval.metrics import AnswerRelevancyMetric

# 1. 재사용할 평가 명세
dataset = EvaluationDataset(
    goldens=[
        Golden(
            input="환불 기간은?",
            expected_output="구매 후 30일 이내입니다.",
            context=["구매 후 30일 이내에 환불할 수 있습니다."],
        )
    ]
)

# 2. 현재 애플리케이션 실행
for golden in dataset.goldens:
    actual_output = my_llm_app(golden.input)

    # 3. 실행 결과를 포함한 평가 단위 생성
    test_case = LLMTestCase(
        input=golden.input,
        actual_output=actual_output,
        expected_output=golden.expected_output,
        context=golden.context,
    )
    dataset.add_test_case(test_case)

# 4. 전체 데이터셋 평가
evaluate(
    test_cases=dataset.test_cases,
    metrics=[AnswerRelevancyMetric()],
)
Golden 데이터의 관리
결국 Golden은 사람이 설계한 논리적 테스트 사례 또는 실행 전 평가 명세라고 할 수 있다. 코드나 json, csv파일 등으로 관리하기에는 케이스양이 많아질 수록 부담이 있고, 이해관계자들의 테스트케이스 리뷰도 힘들어진다.
스프레드시트와 같은 별도의 툴을 이용해서 관리 후, CI 등으로 주기적으로 로컬 파일을 생성해도 되고, 직접 API로 읽어와서 메모리상에서 들고있으면서 핸들링하는 것도 방법일 것 이다.
단 Golden 파일의 스냅샷을 적절히 유지하는 것이 필요하다.
Golden과 LLMTestCase의 관계
Golden은 기존의 스프레드시트의 형태로 작성하던 테스트케이스 라고 생각하면 이해하기 쉽다. LLMTestCase 의 경우는, 이름에 테스트케이스가 들어가서 혼동되기 쉽지만 지표평가를 하기위해 데이터를 모아놓은 일종의 그릇 이라고 생각하면 이해하기 좋을 것 같다.
기존 스프레드시트라면 아래와 같은 포맷일 것이다.
TC ID | 입력 | 기대 결과 | 실제 결과 | Pass/Fail이것을 DeepEval에서는 아래와 같이 다룬다.
Golden
= 입력 + 기대 결과 + 정답 근거
= 실행 전 테스트 명세

LLMTestCase
= Golden의 정보 + 실제 출력 + 실제 검색 결과/도구 호출
= 특정 실행의 결과
그리고 최종적으로 메트릭을 가지고 assert_test() 를 수행하게 되는데, 어떠한 판단 근거를 가지고 pass인지 fail인지를 기록하는 기록자의 역할을 LLM as a judge의 형태로 수행한다.
테스트케이스와 테스트코드의 분리
보통 테스트코드 == 테스트케이스로 이해하는 사람들이 많은데, DeepEval을 사용할 때의 테스트 코드란, 테스트케이스를 실행하는 정말 단순한 코드다.
테스트케이스가 추가되면 그 때마다 테스트 코드를 생성할 수 없다. 따라서 데이터 관리 로직과 테스트 로직을 분리하고, 새로운 데이터가 추가될 때마다 테스트코드를 작성하지 않고 실행할 수 있어야한다.
소수의 유닛테스트는 문제없겠지만, 아래의 경우라면 분리하는 것이 바람직하다.
- 사례가 지속해서 추가되는 경우
- 비개발자가 reference를 리뷰하는 경우
- 데이터 변경과 테스트 로직 변경을 별도로 검토해야 하는 경우
- 여러 테스트나 CI 작업이 같은 dataset을 사용하는 경우
아래 예시는 테스트 데이터와 테스트 케이스를 분리하고, Pytest의 parametrize 를 이용해 동적으로 테스트 id를 설정하고 실행한다.
def case_id_for(golden: Golden) -> str:
    """pytest 리포트와 JSONL 행을 연결할 안정적인 ID를 반환한다."""

    return golden.additional_metadata["case_id"]


def marks_for(golden: Golden) -> list[Any]:
    """Golden metadata를 실제 pytest marker로 변환한다."""

    marker_list: list[Any] = [pytest.mark.full]

    if golden.additional_metadata["suite"] == "smoke":
        marker_list.append(pytest.mark.smoke)
    if golden.additional_metadata["category"] == "known_issue":
        marker_list.append(pytest.mark.known_issue)

    return marker_list


def make_golden_params(goldens: list[Golden]) -> list[Any]:
    """Golden을 안정적인 ID와 marker가 달린 pytest parameter로 바꾼다."""

    return [pytest.param(golden, id=case_id_for(golden=golden), marks=marks_for(golden=golden)) for golden in goldens]


def make_runtime_test_case(golden: Golden) -> LLMTestCase:
    """
    정적 Golden과 현재 앱의 runtime observation을 결합한다.
    런타임으로 테스트케이스를 생성한다.
    Golden reference로 부터 input / expected_output / context / metadata 를 받고
    실제 앱을 실행하여  actual_output / retrieval_context 를 받아
    이것을 하나의 테스트케이스로 생성한다.
    """
    actual_ouput, retrieve_context = answer_refund_question(question=golden.input)


    return LLMTestCase(
        input=golden.input,
        actual_output=actual_ouput,
        retrieval_context=retrieve_context,
        expected_output=golden.expected_output,
        context=golden.context,
        metadata=golden.additional_metadata,
    )

def load_dataset(path: Path = DATASET_PATH) -> EvaluationDataset:
    """현재 작업 디렉터리와 무관하게 로컬 JSONL을 DeepEval로 로드한다."""
    dataset = EvaluationDataset()
    dataset.add_goldens_from_jsonl_file(file_path=str(path))
    return dataset


GOLDENS: Final[list[Golden]] = load_dataset().goldens
GOLDEN_PARAMS: Final = make_golden_params(GOLDENS)

@pytest.mark.parametrize("golden", GOLDEN_PARAMS)
def test_refund_dataset_runtime_contract(
    golden: Golden,
    request: pytest.FixtureRequest,
) -> None:
    """같은 평가 절차를 모든 Golden에 적용한다."""

    test_case = make_runtime_test_case(golden)
    assert_runtime_contract(golden, test_case)
위 코드에서는 pytest.mark.parametrize 데코레이터를 동적으로 생성한다.
- Golden 데이터들에 대해서 Golden 데이터 하나당 id와 marker를 동적으로 만든다.
- 여기서
id는 Golden의 metadata로부터 추출한다.
- 여기서
- 동적으로 생성한 파라미터들을
pytest.mark.parametrize에서 사용한다. - pytest 테스트케이스 내부에서
LLMTestCase또한 동적으로 생성한다.
—collect-only -p 로 출력해보면 아래와 같이 나온다.
tests/evals/test_week3_session4_dataset_regression.py::test_refund_dataset_runtime_contract[refund-known-bug-001]
tests/evals/test_week3_session4_dataset_regression.py::test_refund_dataset_runtime_contract[refund-normal-001]
tests/evals/test_week3_session4_dataset_regression.py::test_refund_dataset_runtime_contract[refund-boundary-001]
tests/evals/test_week3_session4_dataset_regression.py::test_refund_dataset_runtime_contract[refund-unknown-001]
id 덕분에 어떤 테스트가 실패하는지에 대한 traceability확보가 가능해졌다.