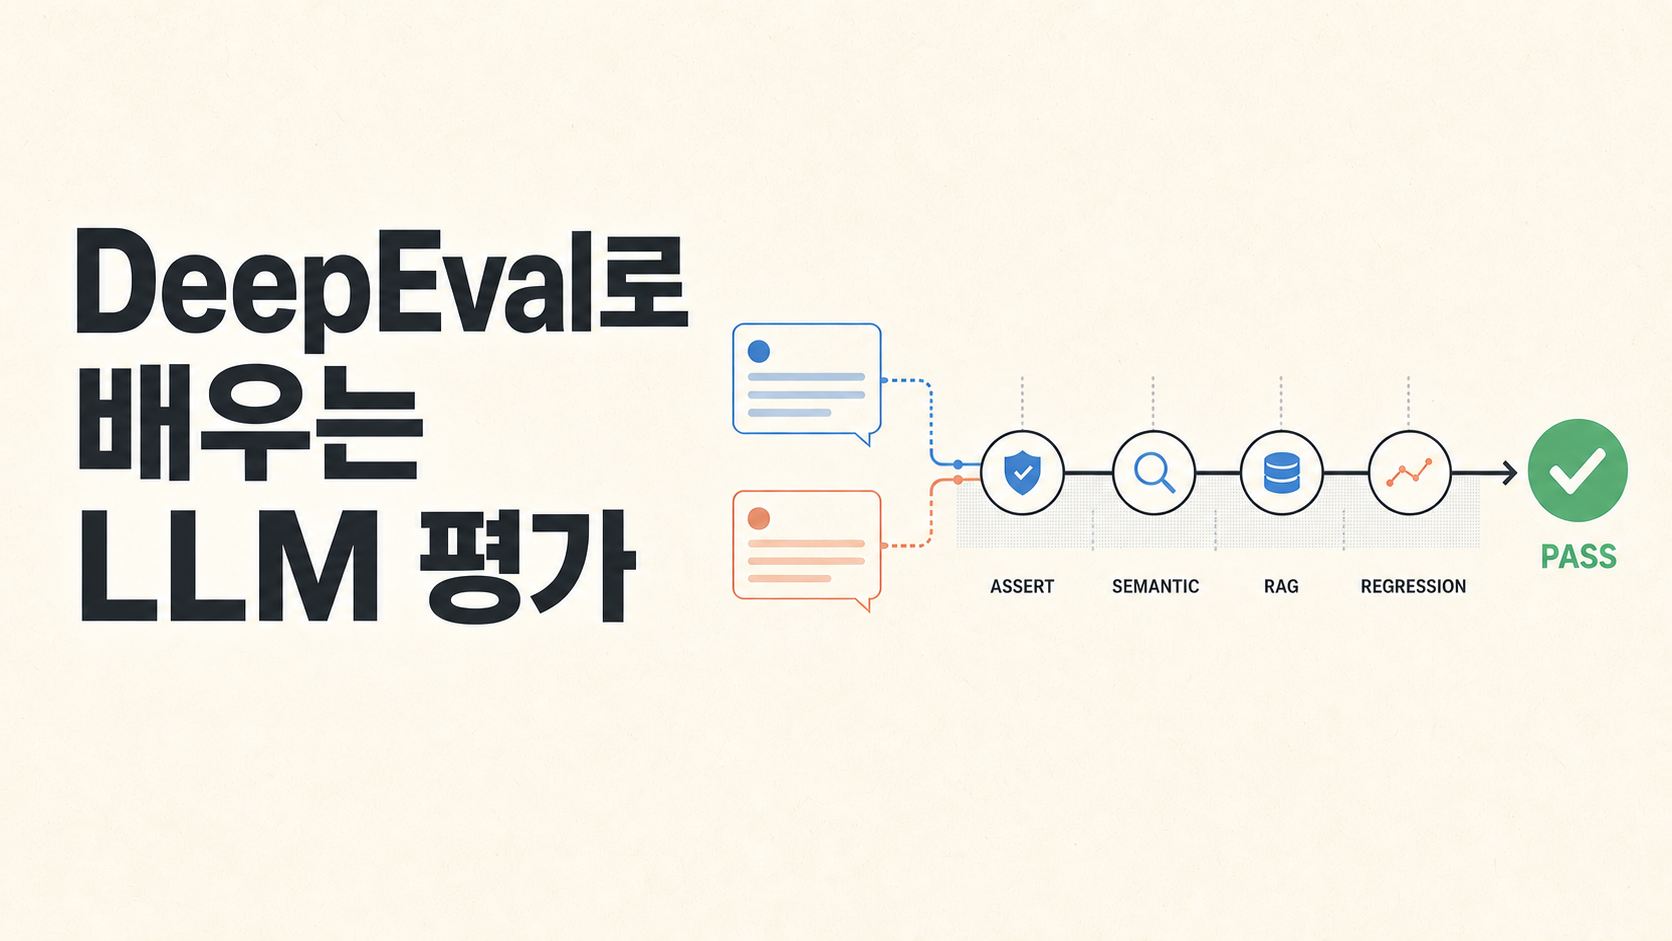
DeepEval?
DeepEval is an open-source LLM evaluation framework for LLM applications. DeepEval makes it extremely easy to build and iterate on LLM (applications) and was built with the following principles in mind:
DeepEval은 llm 어플리케이션 평가를 위한 오픈소스 llm 테스트 프레임워크이다.
AI agent, Chatbots, RAG, MCP 등 llm을 이용한 제품을 만드는 대표적인 경우에서 사용할 수 있는 프레임워크인데, 각각의 경우에 대해 적합한 평가지표(Metric) 들을 제공해주고 있고, 평가지표를 직접 만들 수도 있다.
Pytest와도 통합이 가능하다.
적당한 예시 코드
from deepeval import assert_test
from deepeval.metrics import GEval
from deepeval.test_case import LLMTestCase, SingleTurnParams


def test_refund_answer_is_correct():
    # GEval은 데이터를 어떤 기준으로 평가할지를 정의한다.
    # name : 평가 지표의 이름.
    # criteria : 무엇을 기준으로 채점할 지 자연어로 설명한다.
    #           현재는 실제 답변과 기대답변이 같은 환불 정책을 전달하고 모순된 정보를 추가하지 않았는지를 평가 한다.
    # evaluation_params : 평가모델에게 어떤 데이터를 보여줄지 정한다. 현재는 실제 답변과 기대답변을 비교한다.
    # actual_output + expected_output
    #          ↓
    # criteria를 기준으로 비교
    #           ↓
    # 0~1 점수 산출
    #           ↓
    # 0.7 이상이면 테스트 통과
    # openai 모델이 GEval 평가자로 동작한다.
    correctness = GEval(
        name="Correctness",
        criteria=("Determine whether the actual output communicates the same refund policy as the expected output without adding contradictory information"),
        evaluation_params=[
            SingleTurnParams.ACTUAL_OUTPUT,
            SingleTurnParams.EXPECTED_OUTPUT,
        ],
        threshold=0.7,

    )

    # LLMTestCase는 평가할 데이터를 보관한다.
    # input : 평가모델에게 보여줄 질문.
    # actual_output : 평가모델이 답변한 결과.
    # expected_output : 기대하는 답변.
    # 실제 모델을 평가하려면, 앱에서 생성된 답변을 actual_output에 넣어야한다.
    testcase = LLMTestCase(
        input="구매 후 며칠 안에 환불할 수 있나요?",
        actual_output="환불은 불가능합니다",
        expected_output="모든 고객은 구매 후 30일 안에 전액 환불을 받을 수 있습니다.",
    )

    # testcase에 평가지표를 넣고 테스트를 실행한다.
    # actual_output과 expected_output을 GEval로 비교한다.
    assert_test(testcase, [correctness])
- GEval : 평가기준/Metric.
- criteria : 무엇을 기준으로 채점할지를 자연어로 설명한다. 기본적으로는 llm-as-a-judge 이므로, 이 평가기준을 이용해 llm 모델이 평가자로 동작한다. 기본 모델은 gpt 5.4 모델이다. 즉, 이 프레임워크를 사용하려면 기본적으로는 ai model api key가 필요하다.
- evaluation_params : 어떤 값들을 평가 대상으로 할지를 정한다. 예시의 간단한 코드에서는 실제 출력과 기대 출력가느이 비교를 한다.
- LLMTestCase : 평가할 데이터.
- actual_output은 실제 채점할 llm의 응답값을 넣어준다.
- expected_output 은 내가 해당 llm에 기대한 응답값.
- assert_test
- 실제값과 기대값에 대해 GEval을 이용해 비교분석 검증한다.
QA Engineer